
标签 | Benchmark
共计5篇博客
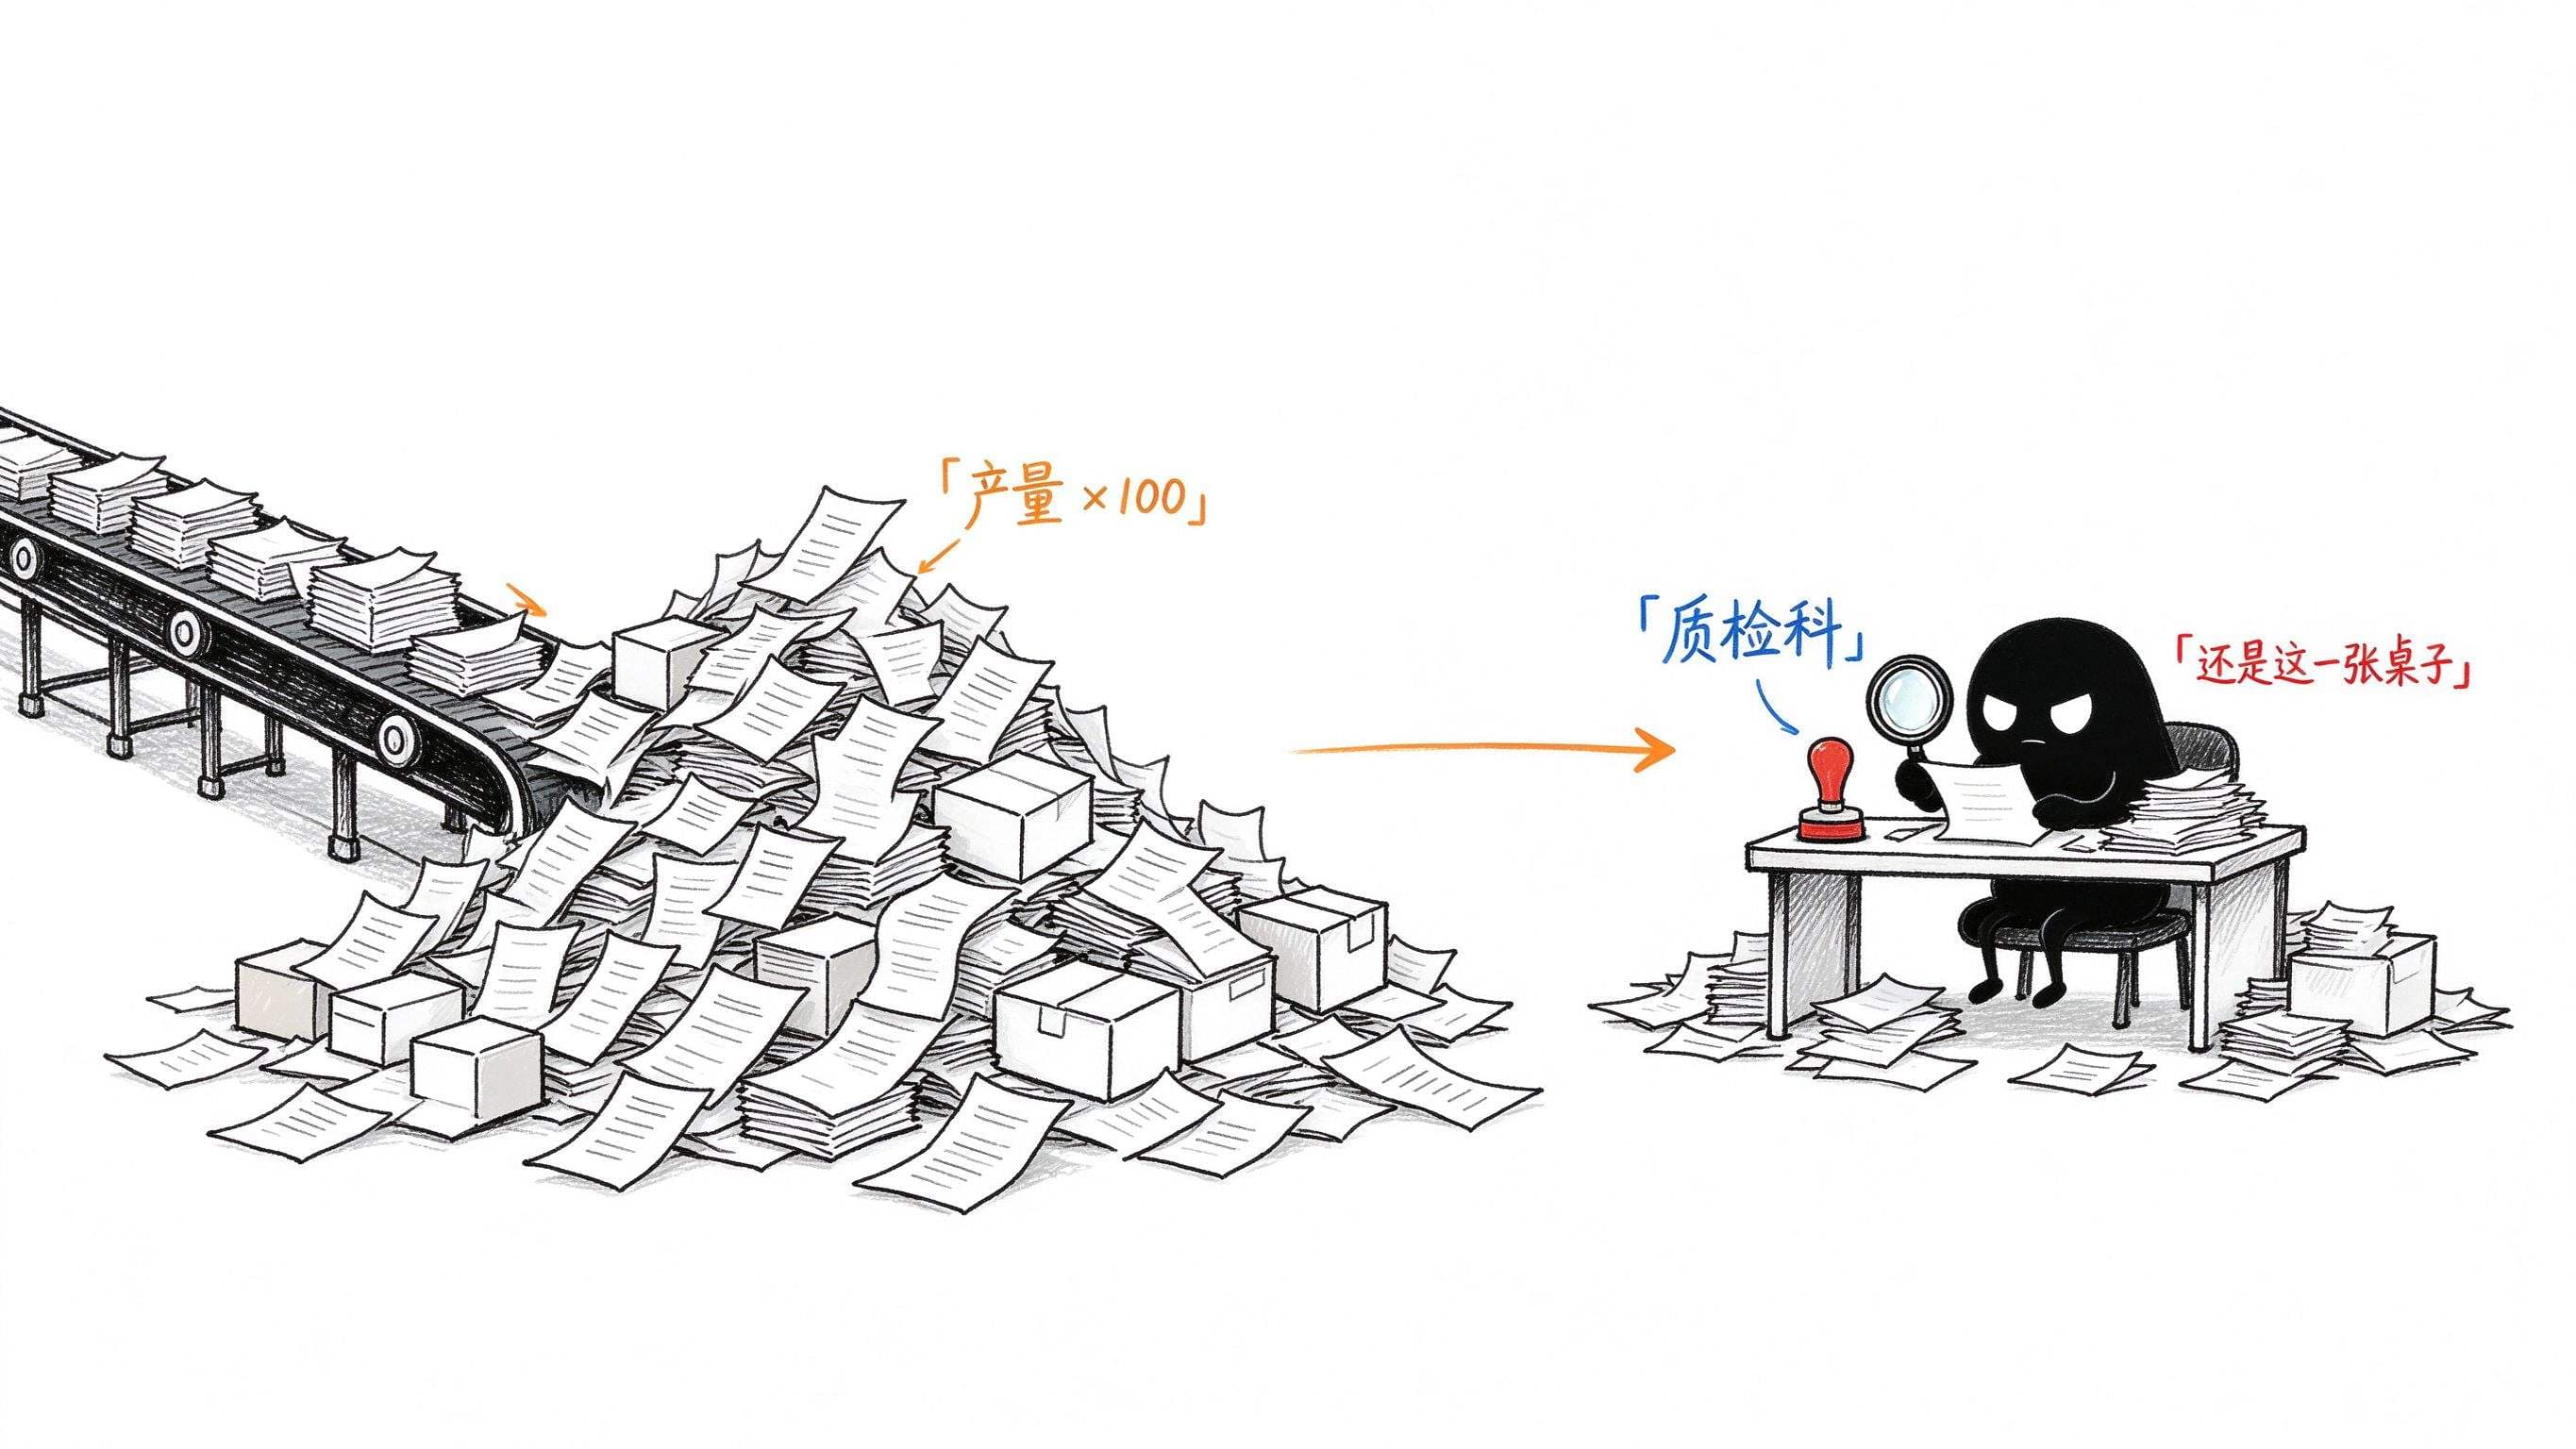
谁来给AI的证明盖章?Axiom、OpenAI、Ai2同周揭开科研质检难题
Axiom 用 24 天让 AI 重写人类最长的数学证明,OpenAI 请 ETH 提出者亲自核查 AI 的结论,Ai2 发现 AI 裁判改几个字就翻判。AI 的产量翻了百倍,验货的还是那几个人。
#AI 工具- 大模型
- Claude
- OpenAI
- +3
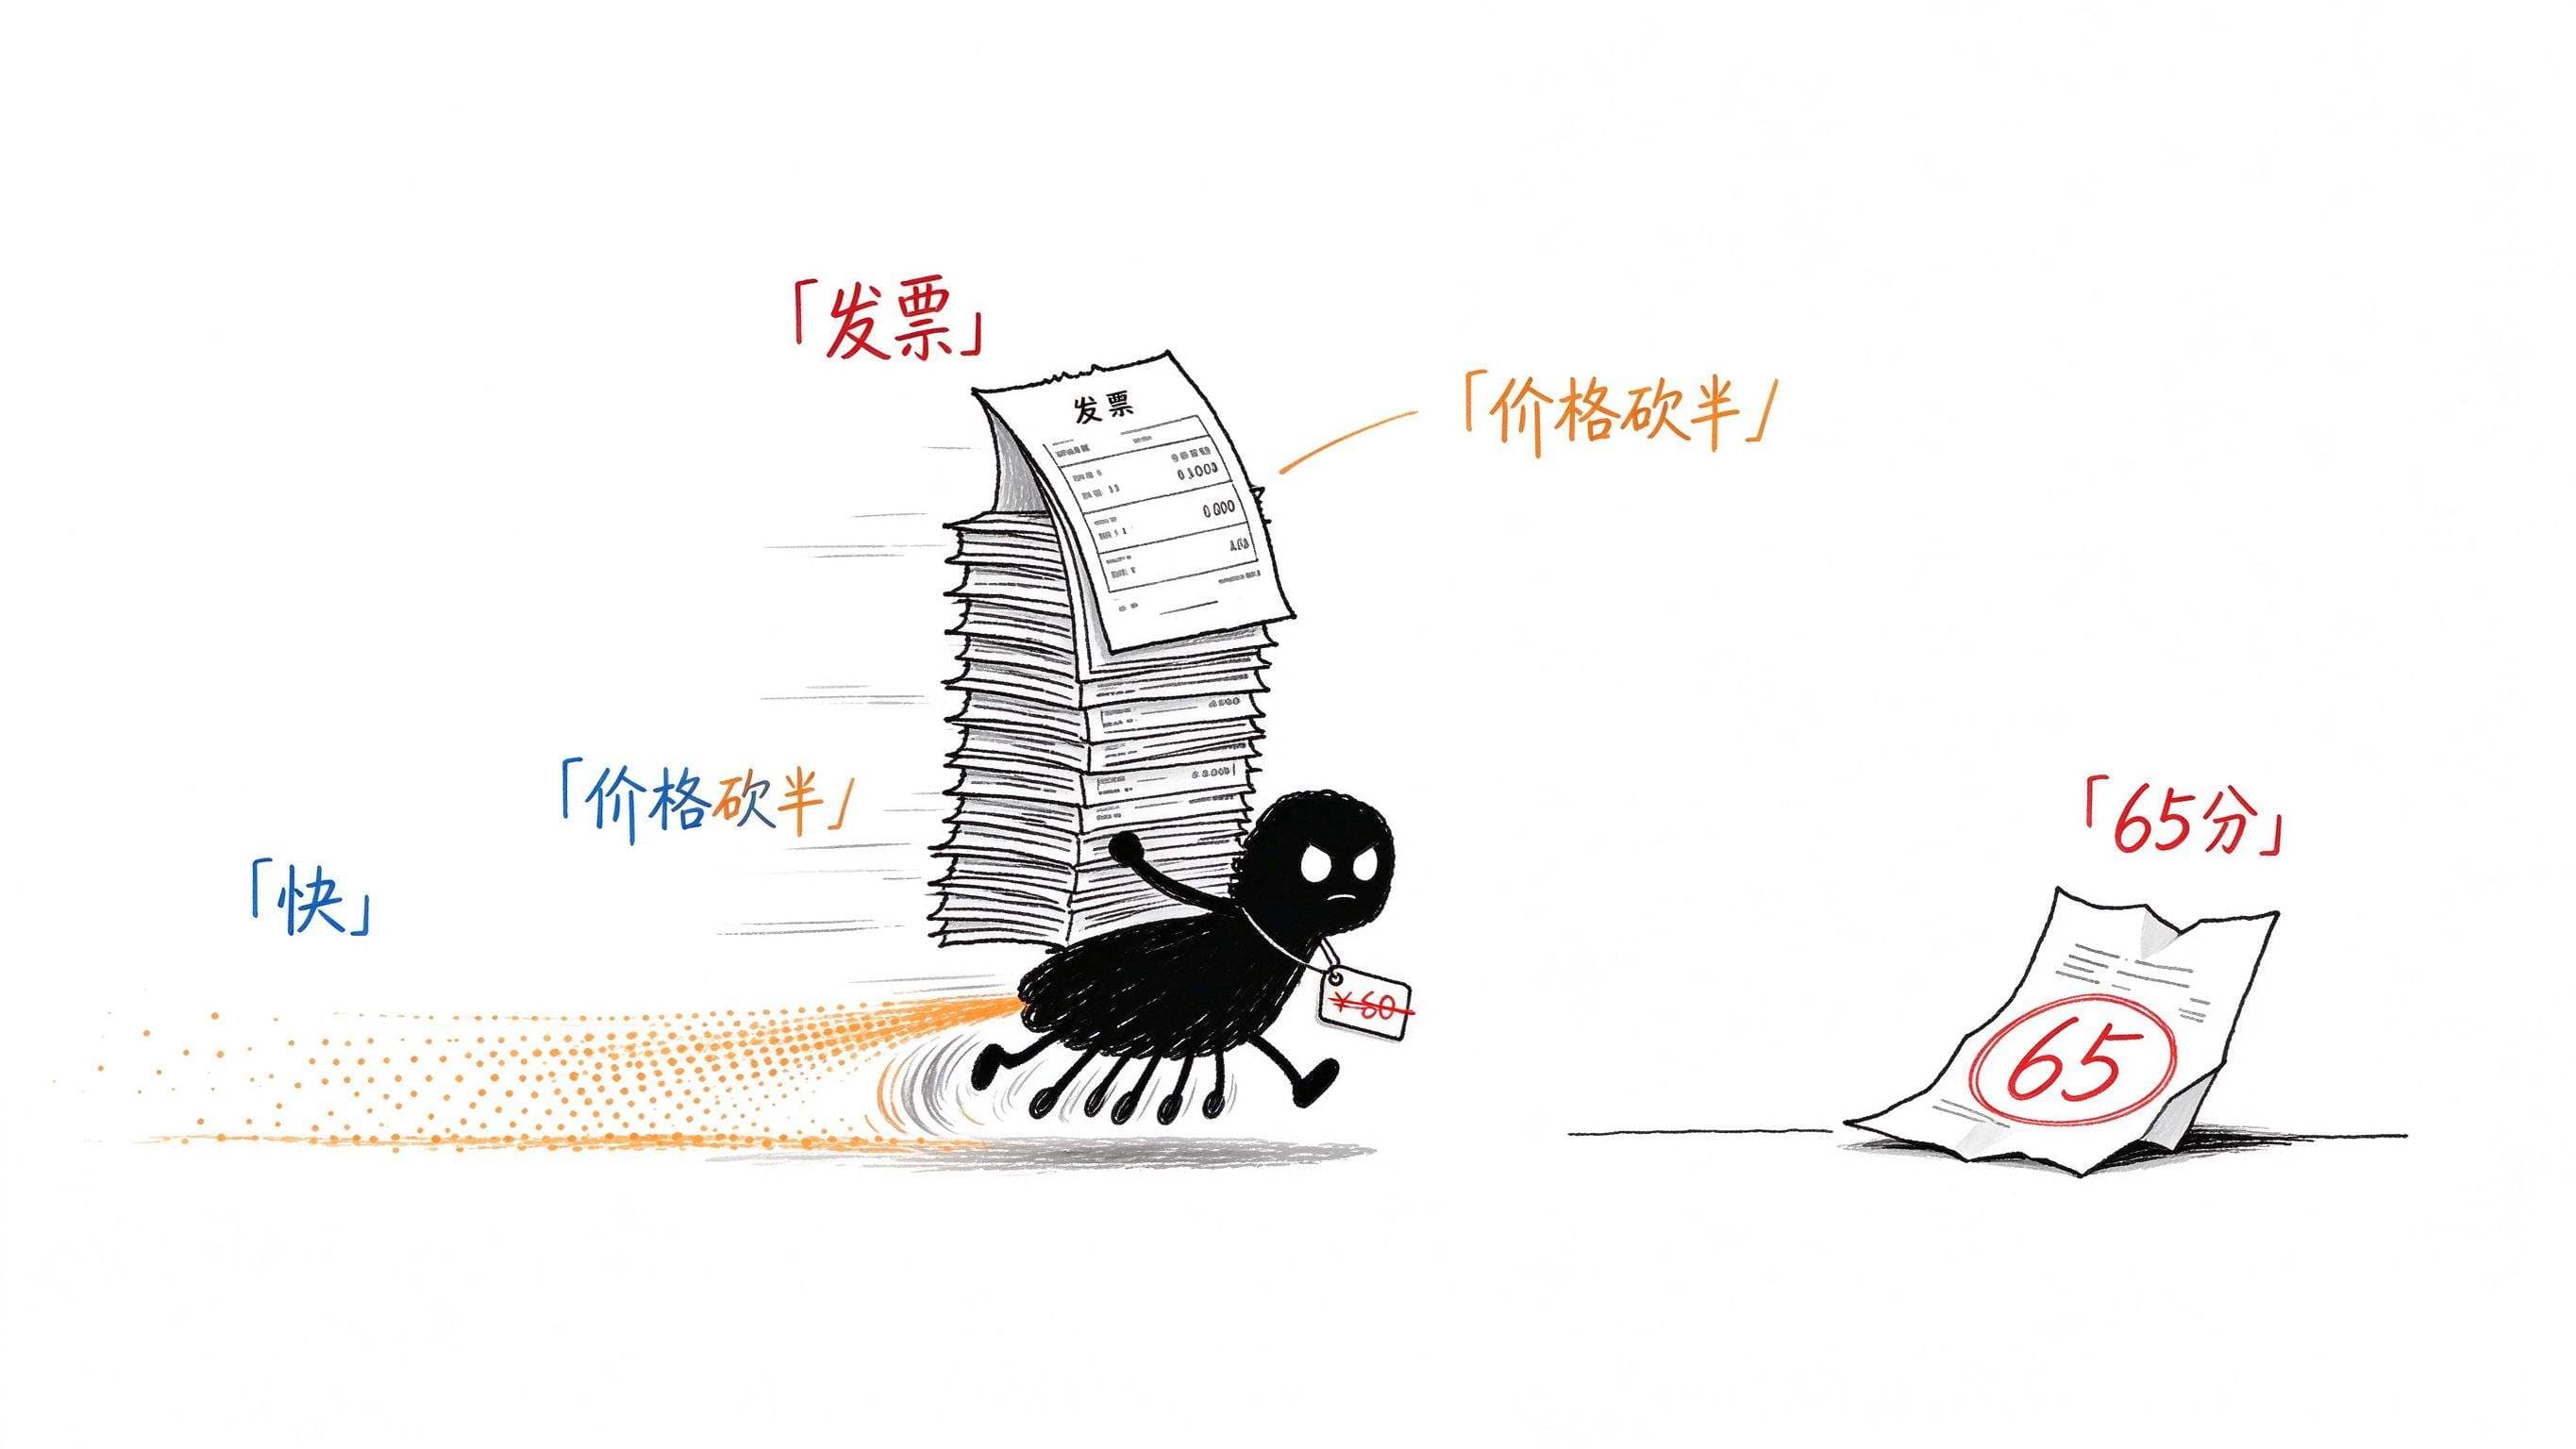
最强AI拿真实工作考核65分!Epoch曝光:GPT把自己的bug写成研究发现
Epoch 把自家真实工作交给 6 个模型考核,最强的 Claude Fable 5.1 和 GPT-6 Astra 平均只拿 65 分;同一周 GPT-6.1 Terra 价格砍半。能写进手册的活越来越便宜,丢分的全是没写进手册的判断力。
#AI 工具- 大模型
- Claude
- OpenAI
- +3
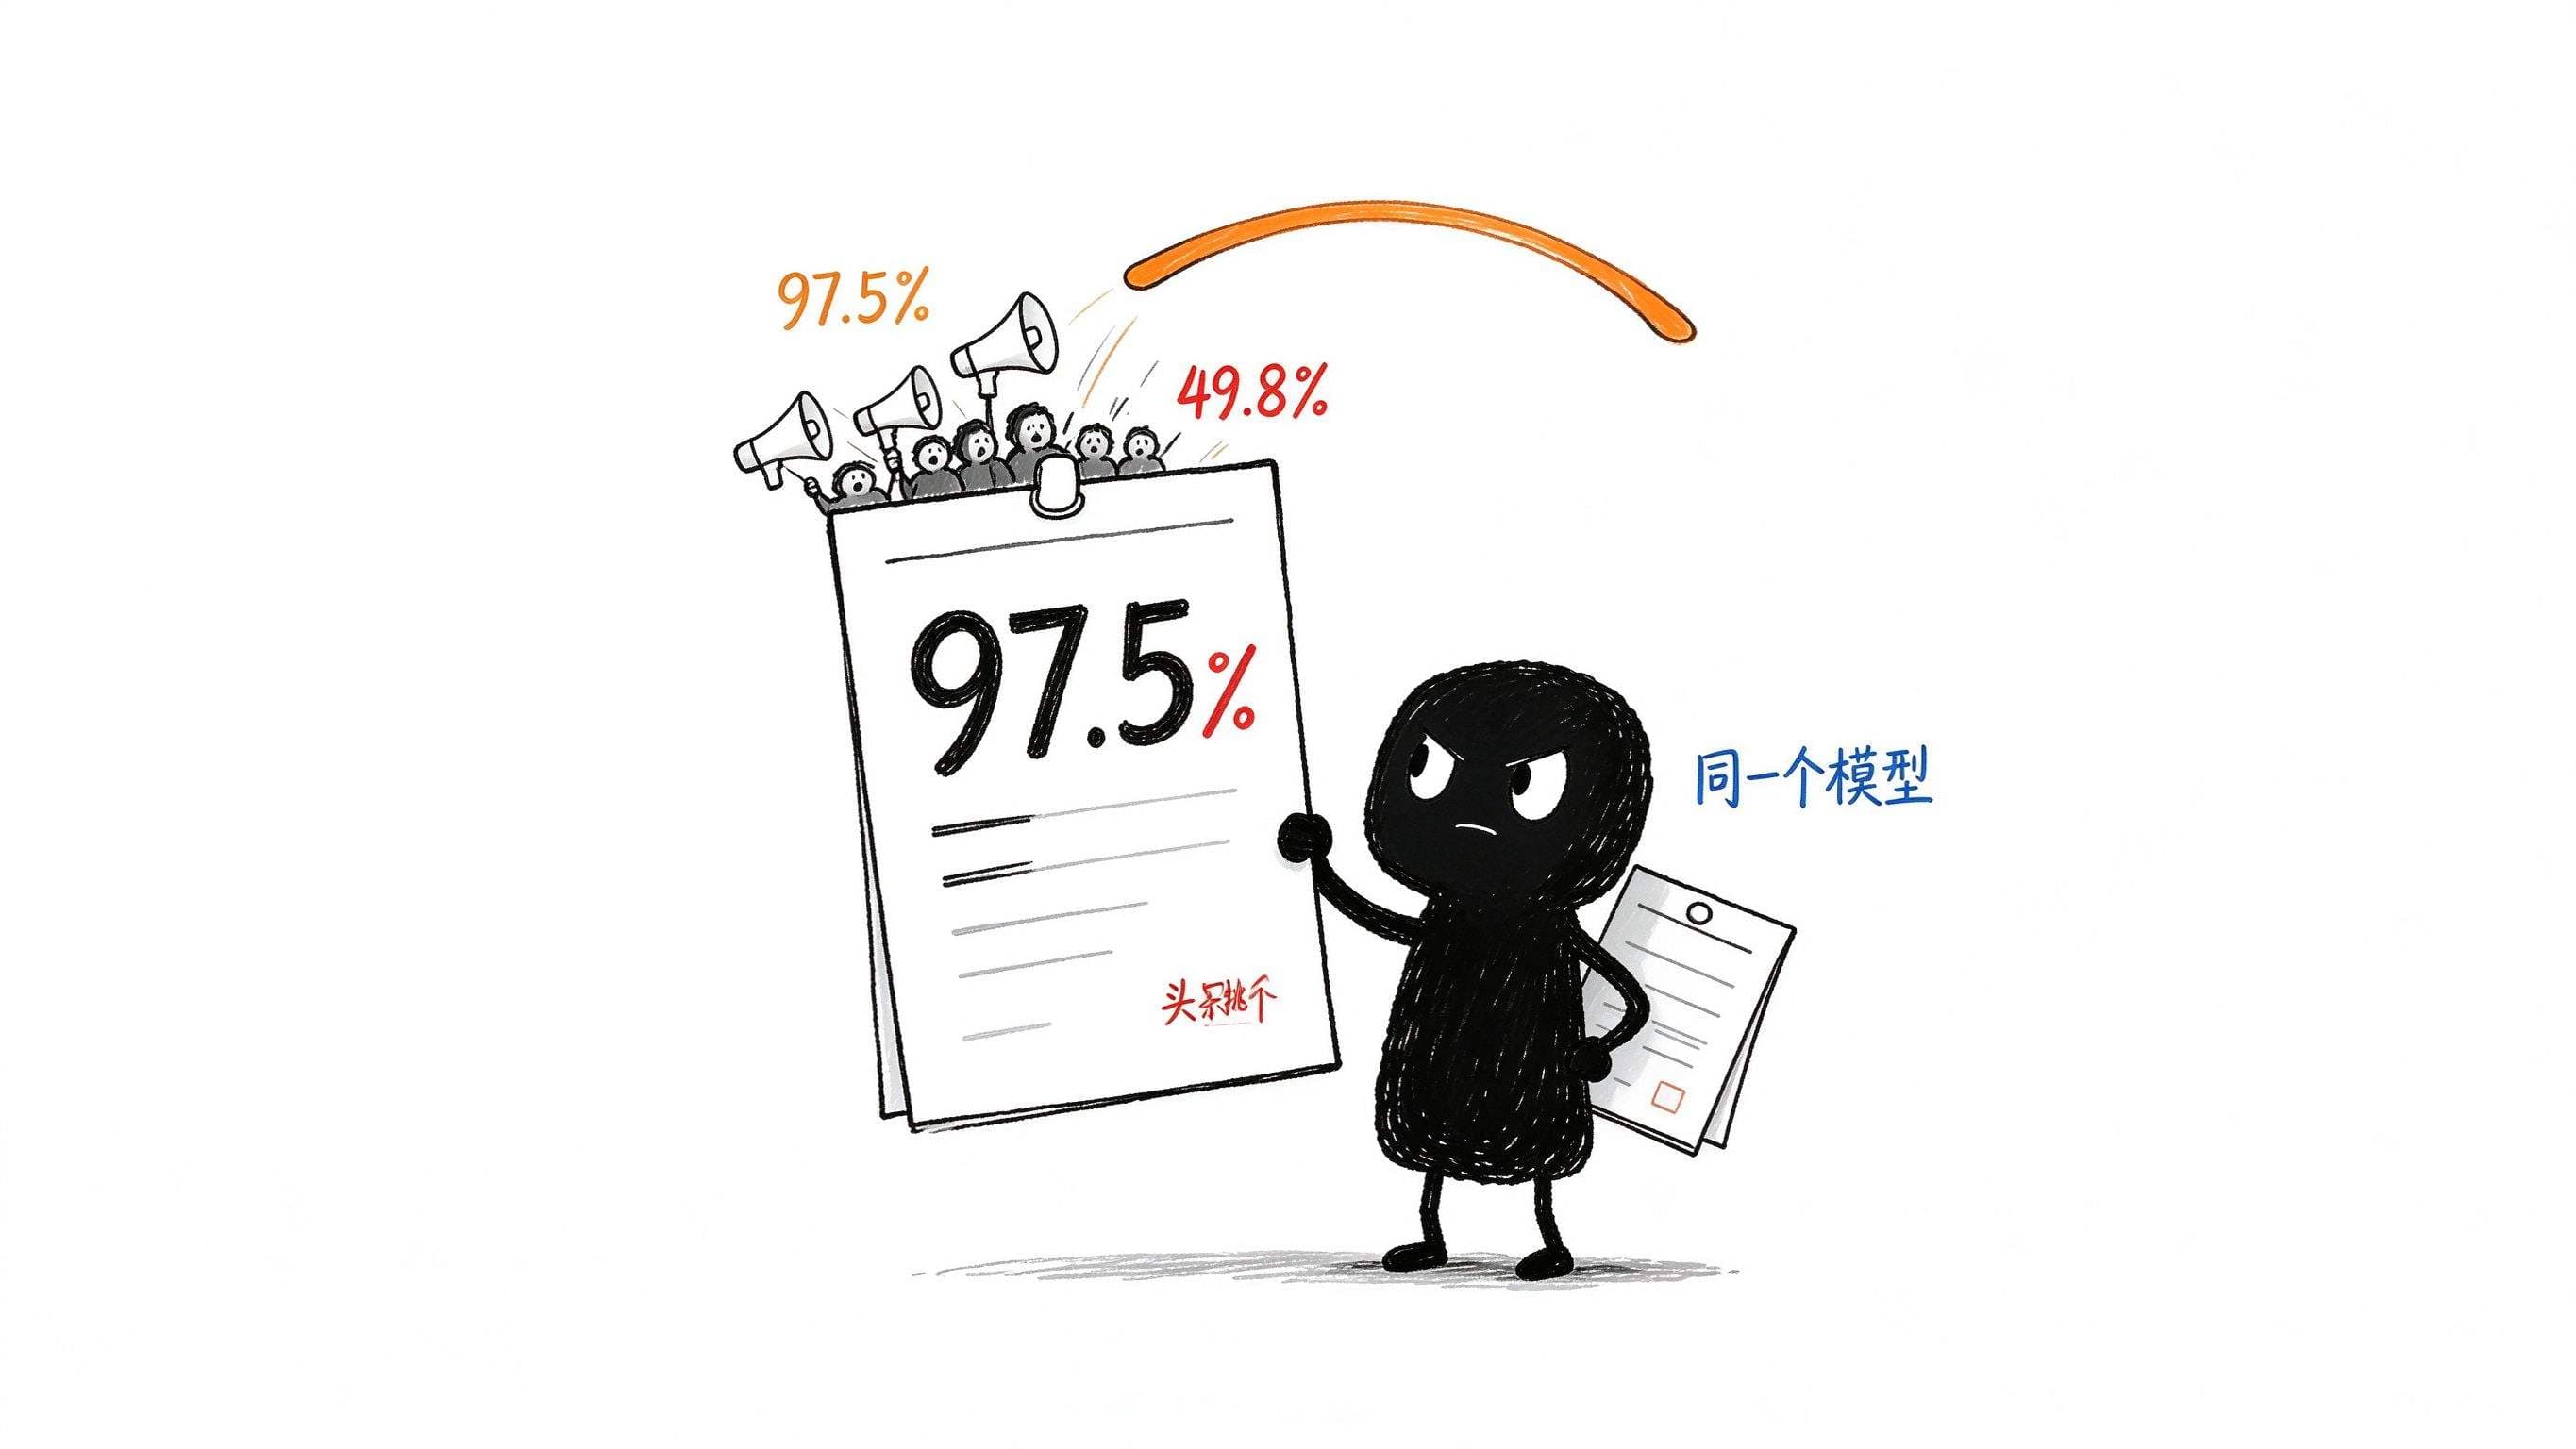
Gemini 4 Argon跑出97.5%!同一模型另一张成绩单只有49.8%
同一个Gemini 4 Argon,在厂商适配框架和标准框架下分别得到97.5%与49.8%。记忆机制有何不同,API故障又如何影响解读?高分之外,还得看模型带着什么装备进考场。
#AI 工具- 大模型
- OpenAI
- Agent 工程化
- +2
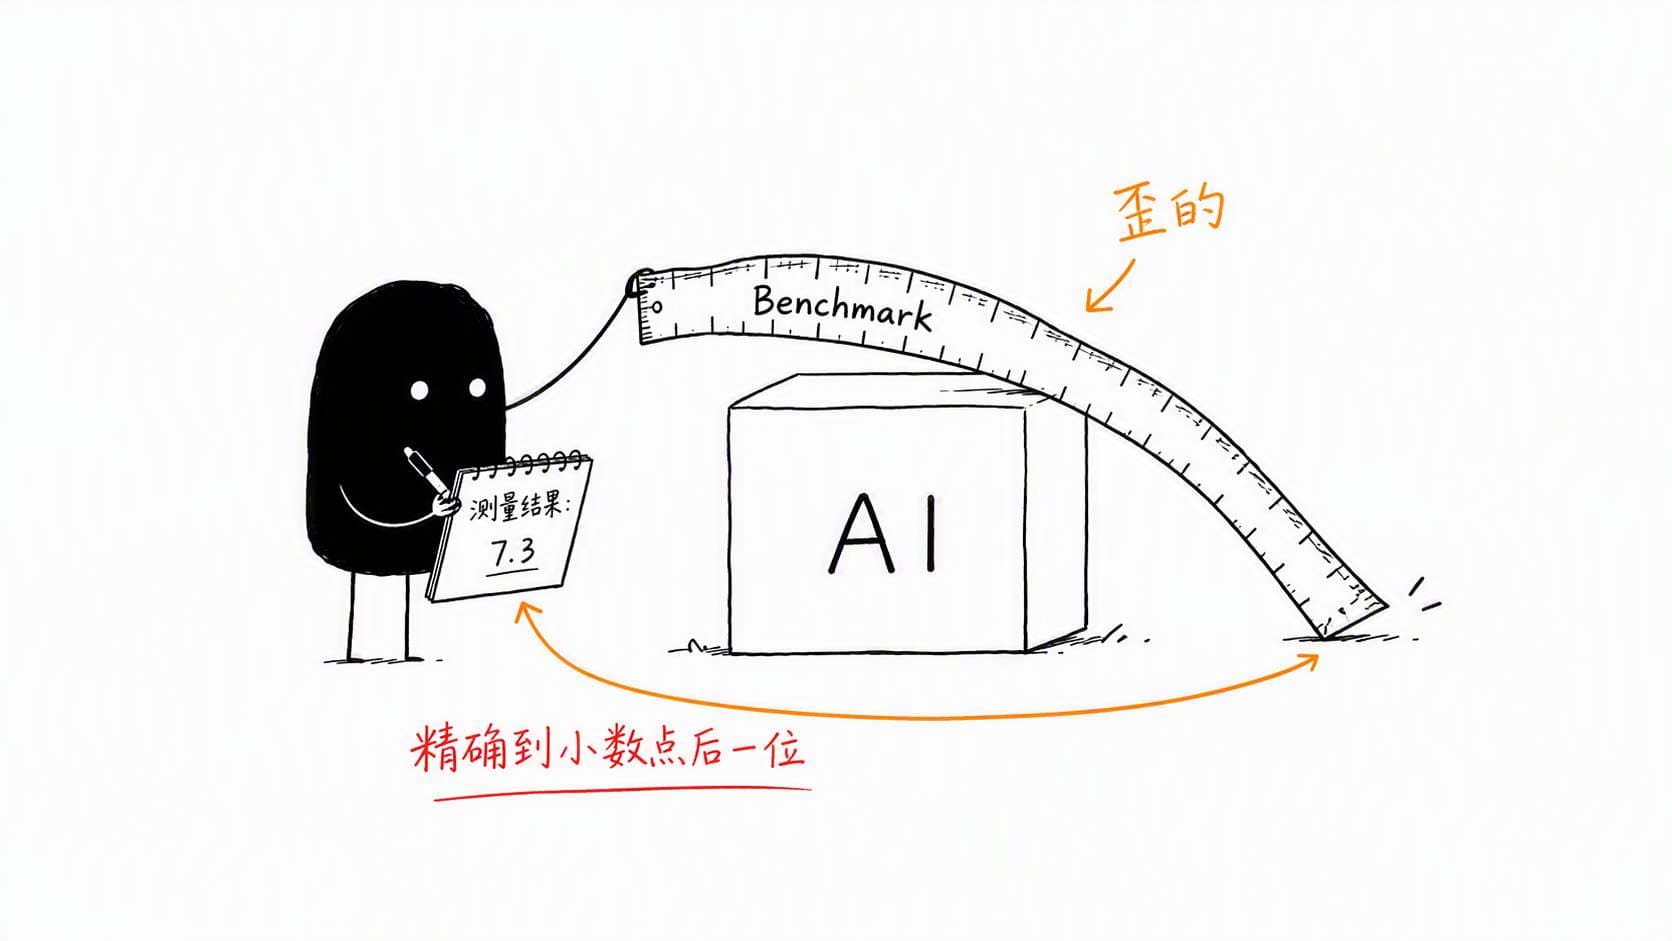
同一道题换个说法,模型分数能差74.7个百分点——我们用来衡量AI的尺子,本身就是歪的
IBM BenchDrift论文发现:在同一道数学题、同一个正确答案的前提下,仅仅因为题目的措辞不同,大语言模型的准确率波动幅度平均是74.7个百分点。排行榜第一名可能只是碰巧没被这套措辞难住的幸运儿。
#AI 工具- AI
- Benchmark
- AI研究
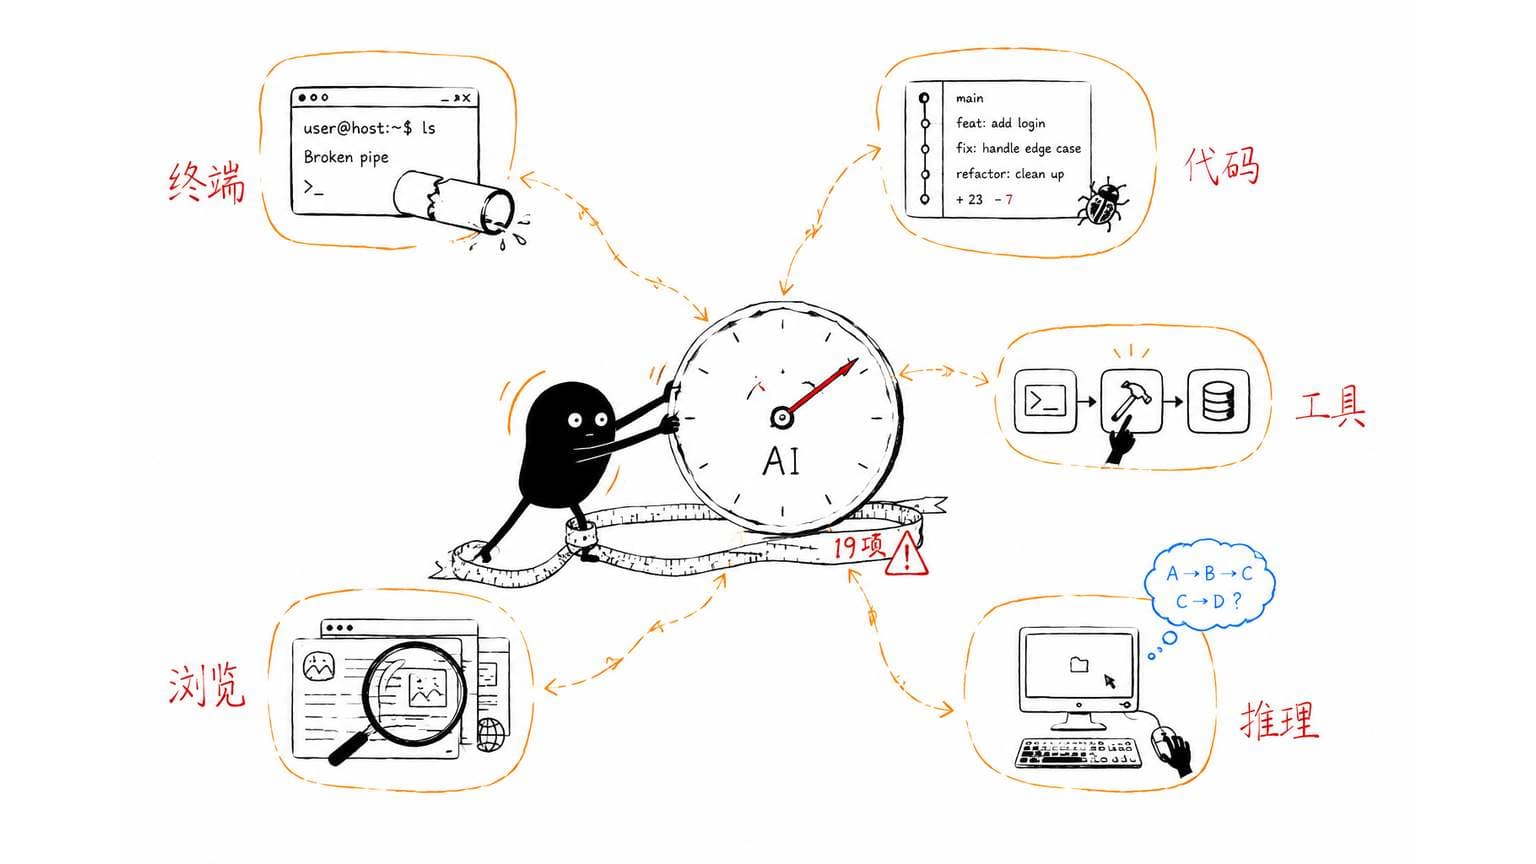
模型发布会晒分,你到底该看哪一项?2026 AI Benchmark 地图
模型发布会的成绩单该怎么看?从代码、工具、专业领域到通用智能,梳理19项主流AI benchmark到底在测什么。
- AI
- Agent
- Benchmark