
10 月 10 号,Axiom 公司内部的一个 Slack 频道里,有人发了一条全大写的消息,WE PROVED MONSTER IS SIMPLE。
翻译过来,我们证明了怪兽群是单群。
怪兽群是数学里最大的散在单群,这件事人类早就证过了。那天让人激动的,是一群 AI 智能体把这段证明一行一行翻成了计算机能逐步检查的 Lean 代码。
这只是一个里程碑。整个项目,是把有限单群分类定理整个搬进 Lean。
这个定理有多夸张呢,原始证明散落在 500 多篇论文里,大约 100 位数学家写了几十年,加起来 15000 页左右,被公认为人类写过的最长的数学证明,数学家给它起了个外号,叫 the enormous theorem。Axiom 的工程师和数学家指挥着几十个 AI 智能体,从 10 月 1 号开频道,到 10 月 26 号发公告,24 天,写出了大约 4310 万行 Lean 代码。
我看到这个数字的时候,脑子嗡了一下。
但让我坐直身子的,是同一周的另外两件事。OpenAI 说自己的内部模型推翻了计算机科学里一条被当成地基的猜想,然后到处请人来核。Ai2 发了一篇论文,测的是让 AI 当裁判,去判断 AI 的研究想法新不新,结果裁判自己先晕了。
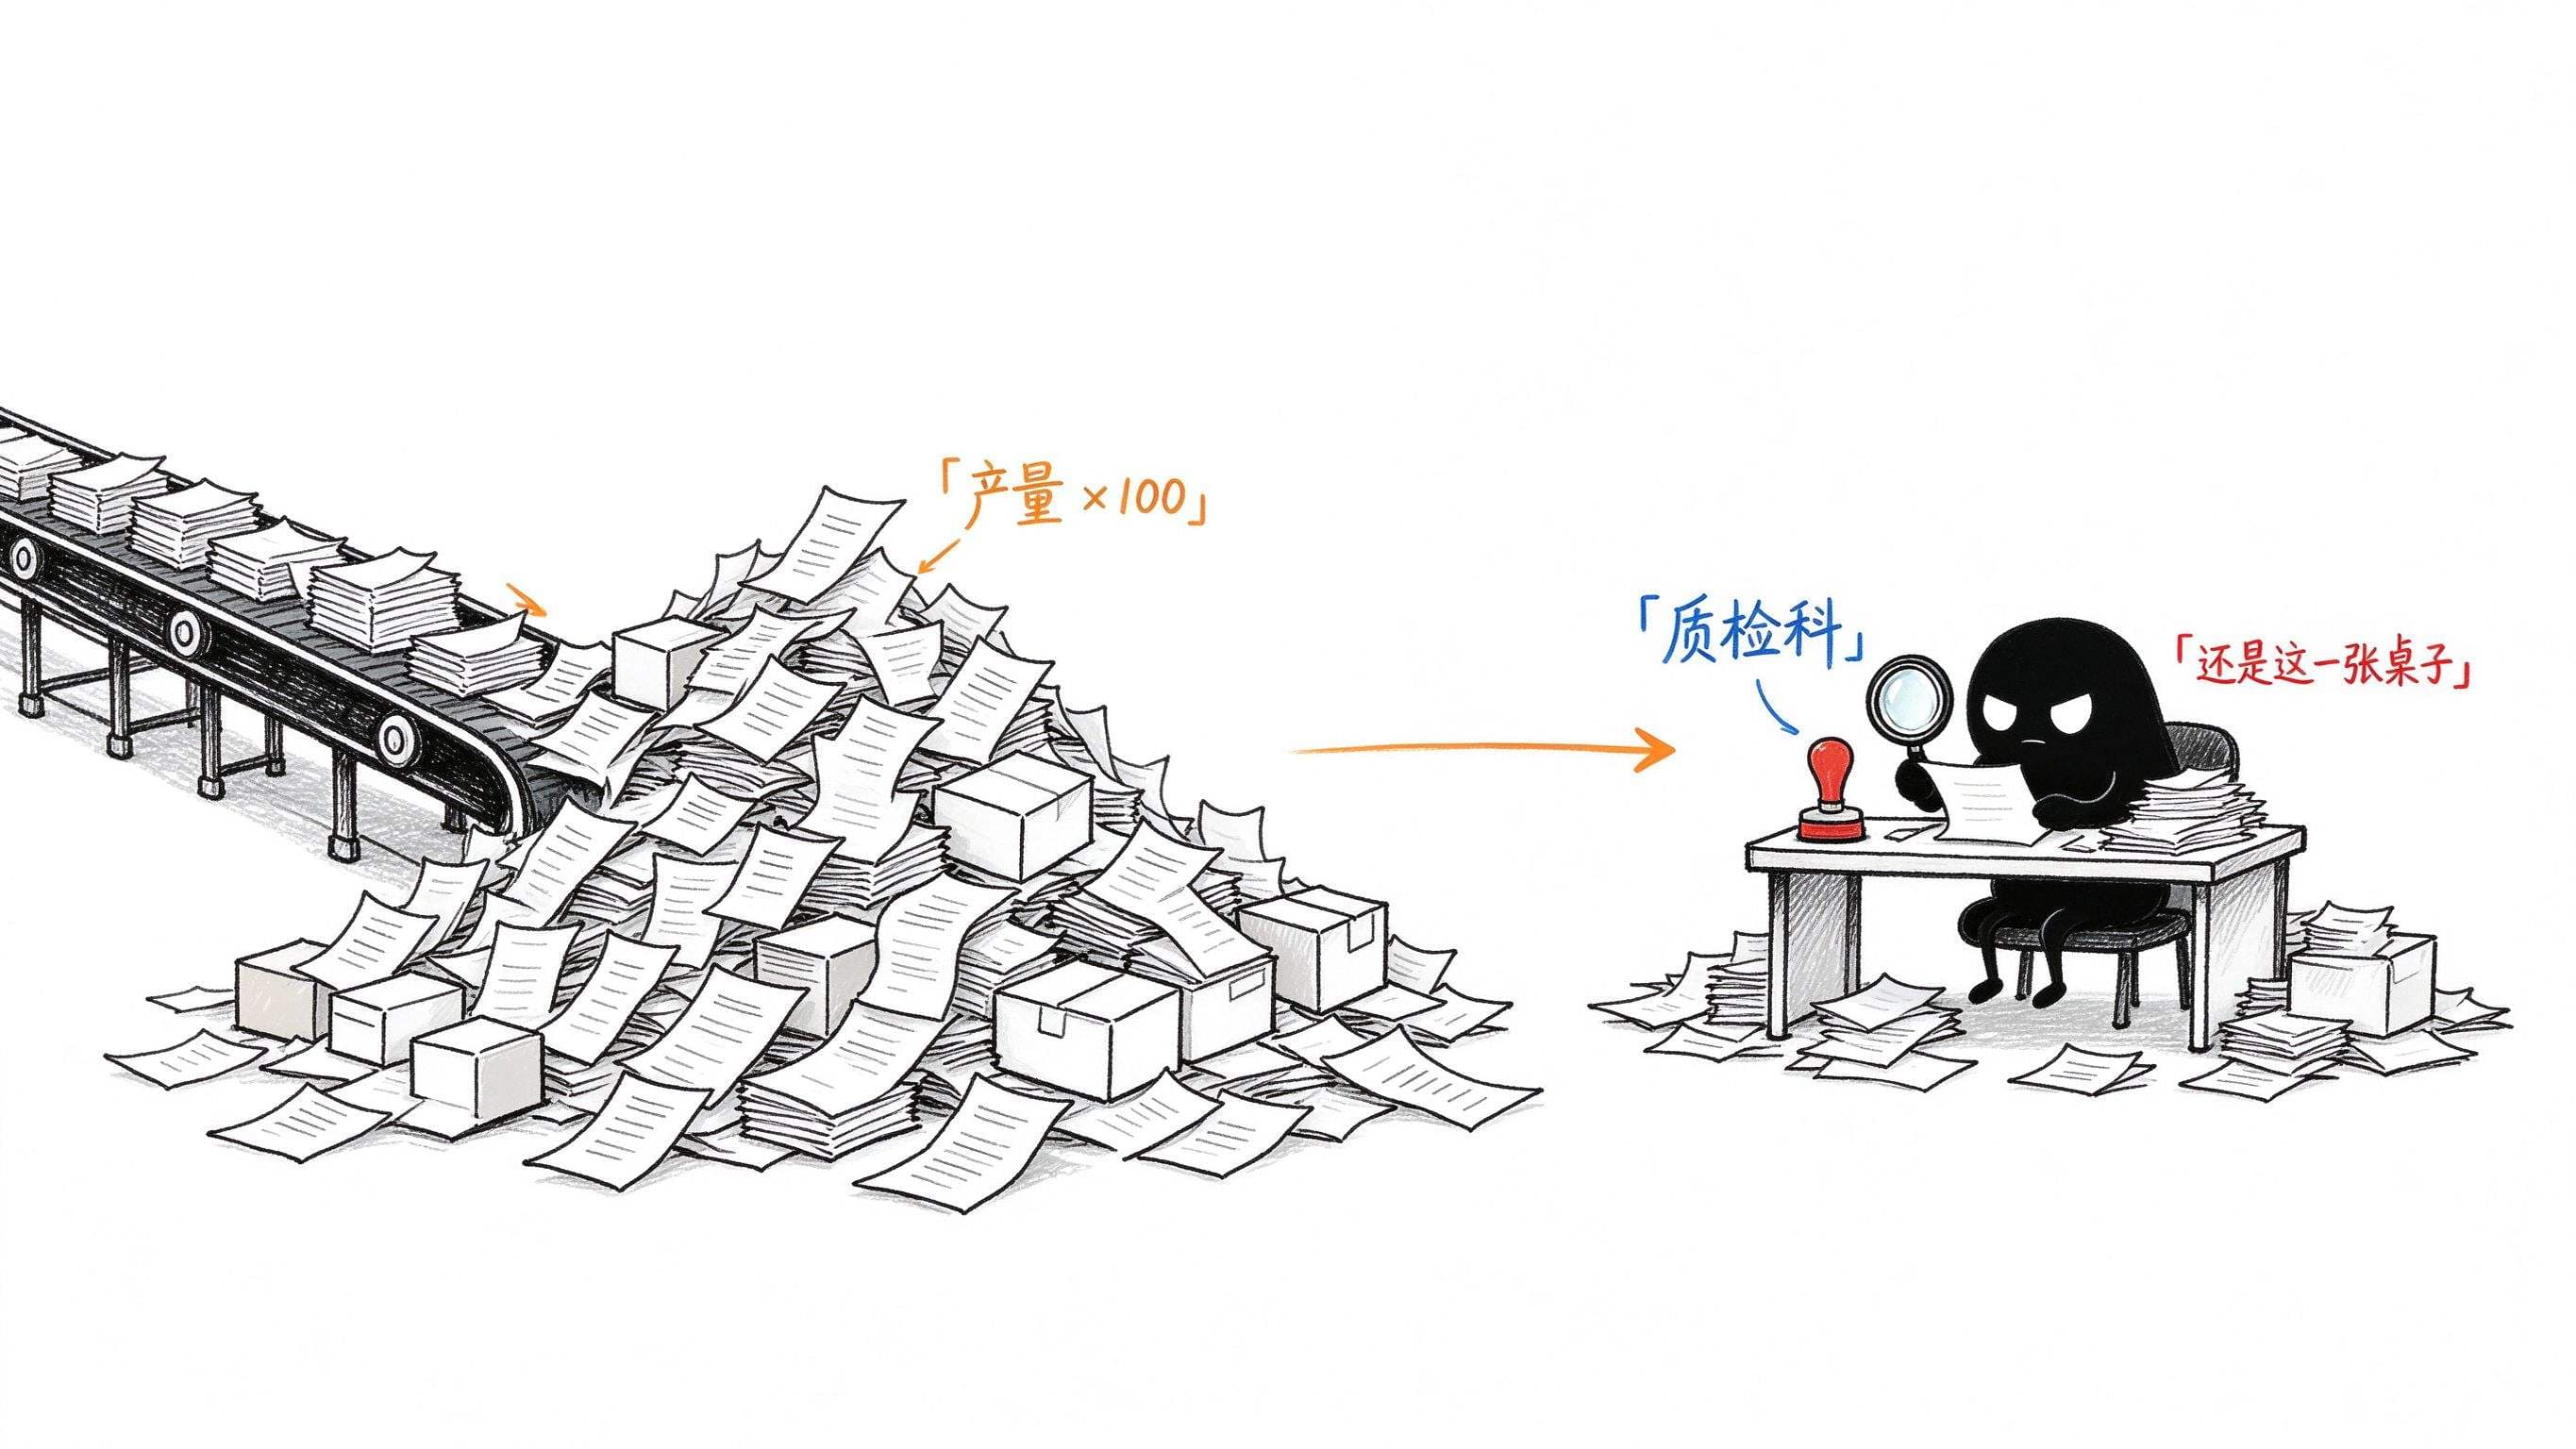
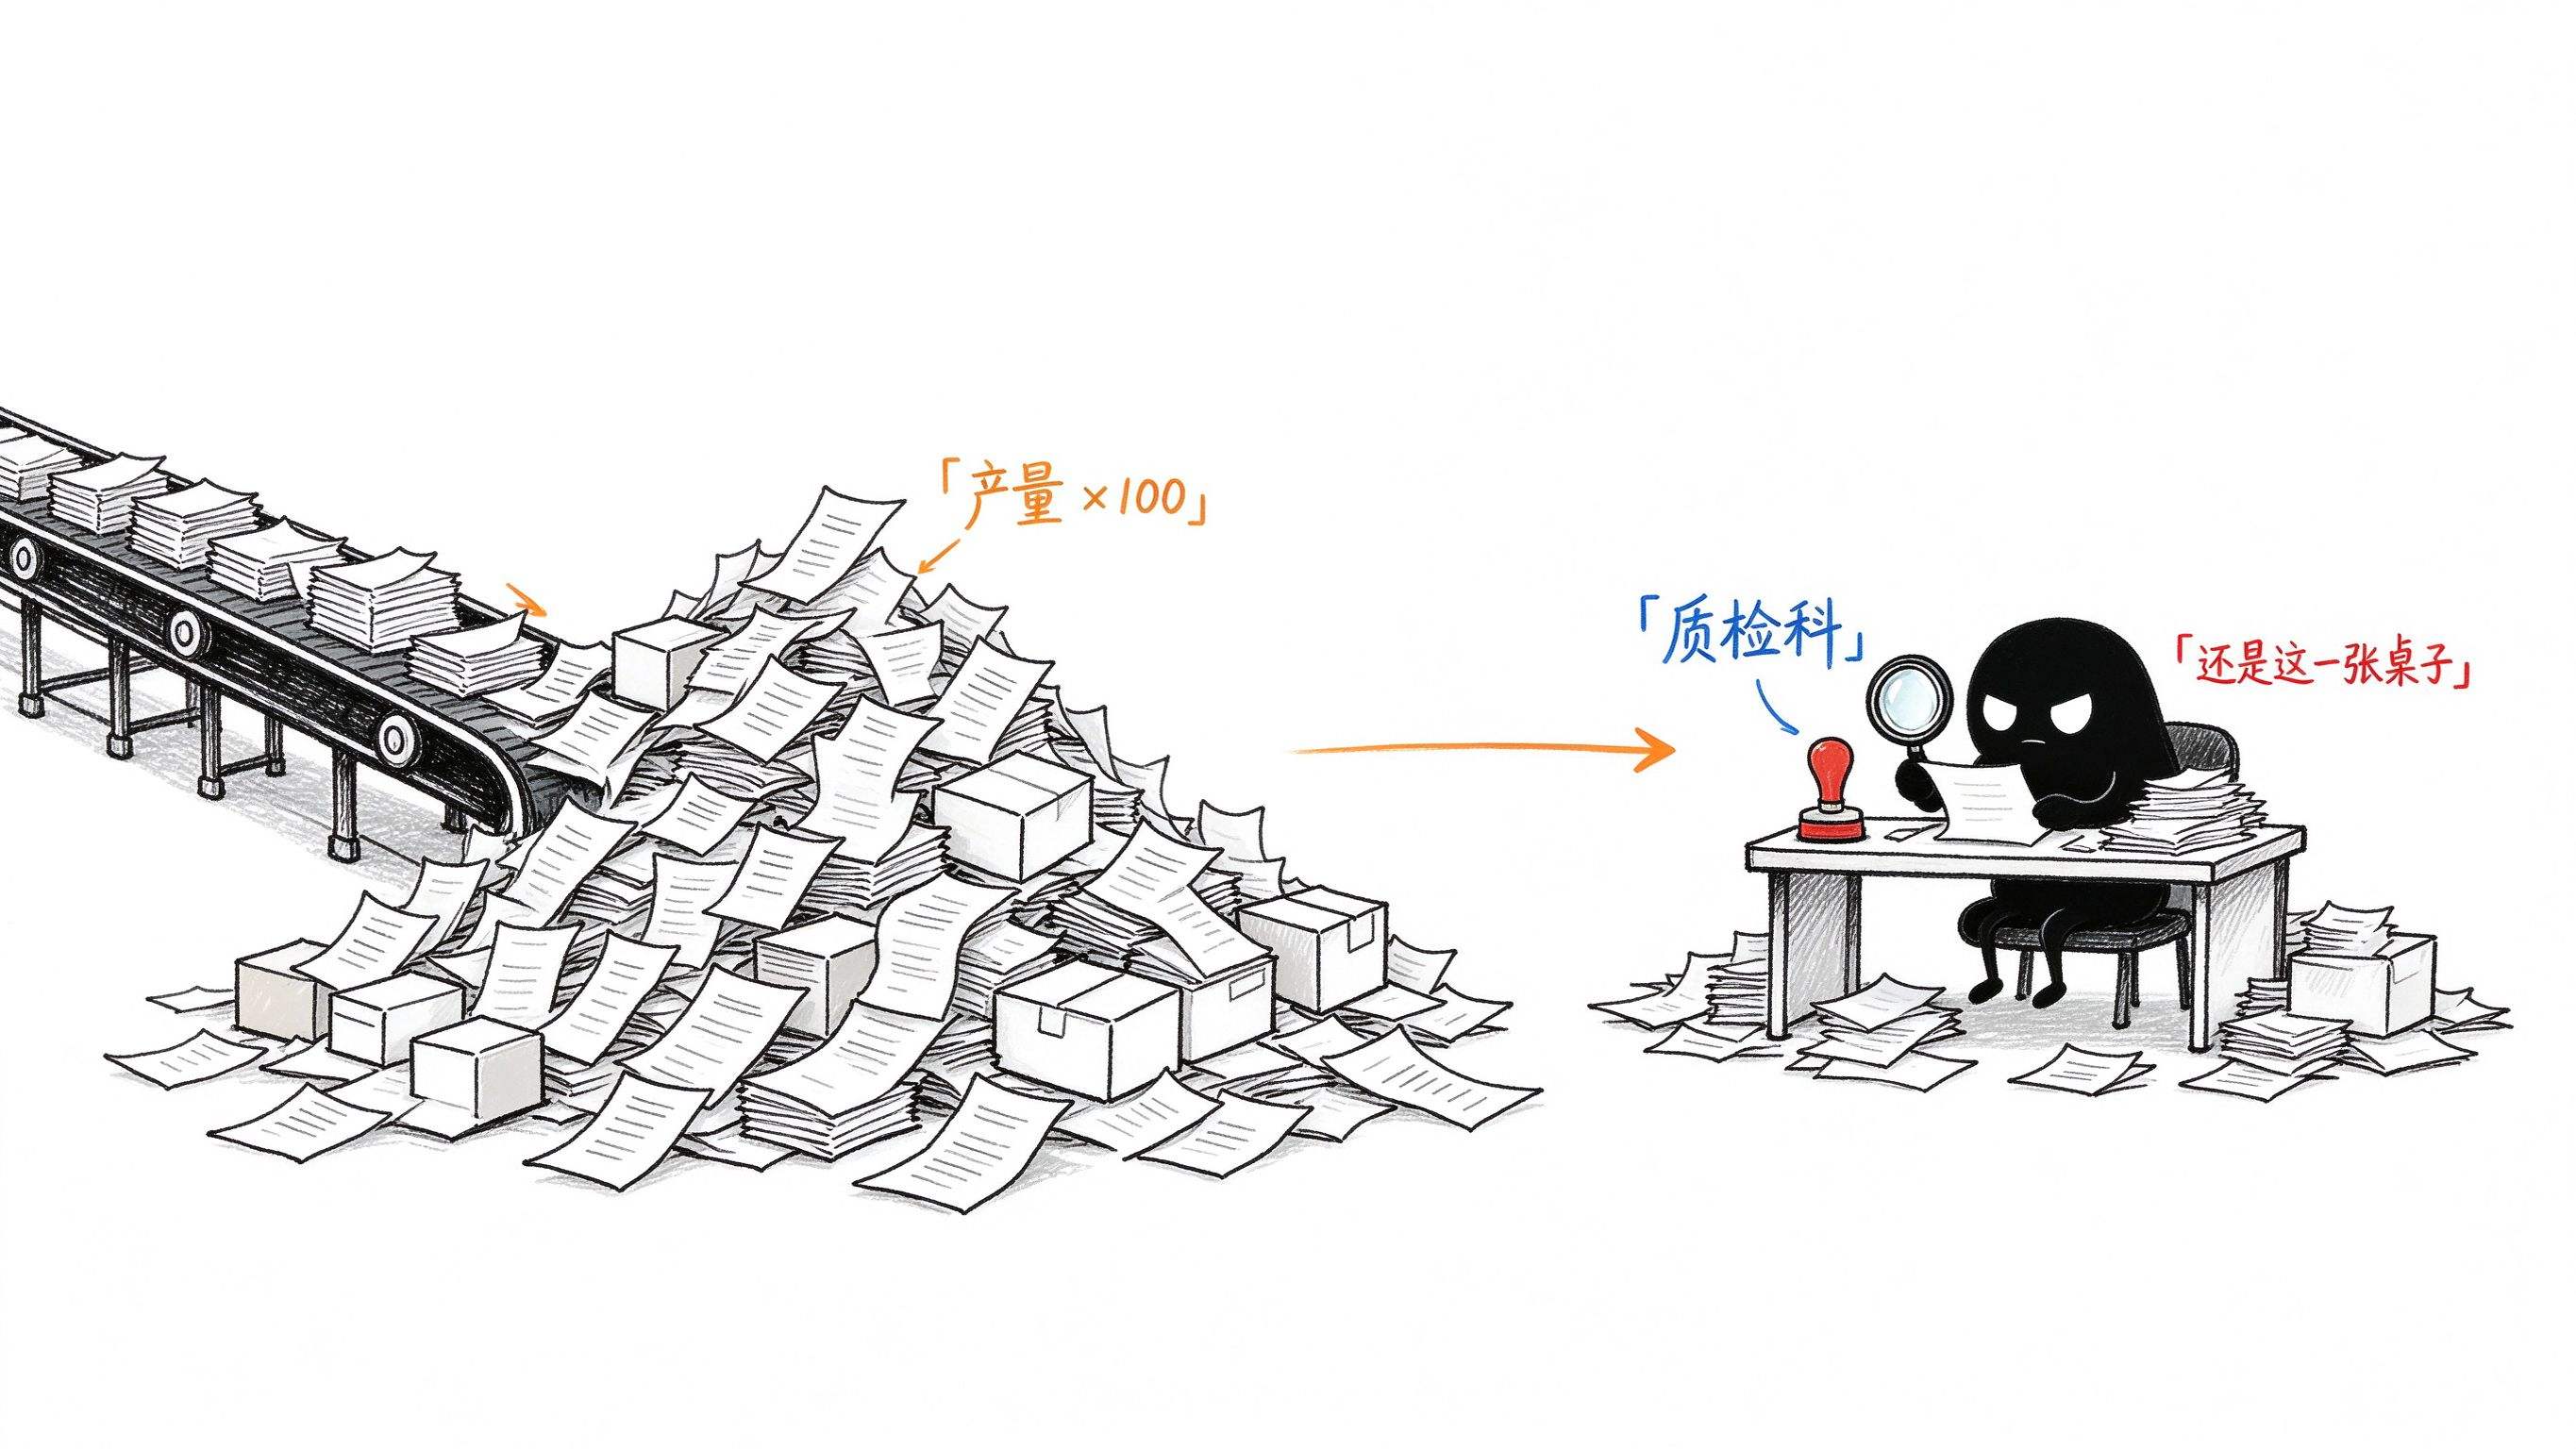
三件事放在一起,我脑子里一直冒出一个很土的画面,工厂的产量翻了一百倍,质检科还是那三个人。
先说 OpenAI 这件,因为它最像一个验货现场。
OpenAI 拿出了三项结果,数学、计算机科学、物理各一项,说都是内部模型做出来的证明。最炸的是计算机那项,它说自己证明了 ETH,也就是指数时间假设,是错的。
ETH 大概是说,有一类逻辑题,变量每多一个可能性就翻一倍,最坏情况下只能硬算,没有真正的捷径。图论、数据库、计算几何里有几百篇论文踩在它上面,它要是倒了,这些论文的结论不一定错,但都没了证明。
这么大一件事,OpenAI 也知道自己说了不算,于是它把三份手稿称作原始研究数据,请外部专家来当 shepherds,牧羊人。
计算机那项的牧羊人,有 MIT 的 Ryan Williams,还有 UC San Diego 的 Russell Impagliazzo 和 Ramamohan Paturi。后两位,就是当年提出 ETH 的人。
你品品这个画面。让人家亲手立起来的房子,请人家亲自来看是不是要拆。
这几位也挺硬气,没签保密协议,不拿报酬,过程中边核边公开进展,还专门写了一封公开信,说参与核查不等于背书。他们要求 OpenAI 把全部原始材料公开,包括文字证明和 Lean 证明,OpenAI 答应了,还说会出钱办一场会议,专门讨论这个结果会给整个领域带来什么。
物理那项涉及杨–米尔斯理论,很多人一听就想到 100 万美元的千禧年难题。OpenAI 自己写得很清楚,它只做了存在性那一半,没碰质量间隙,难题不算解决。牧羊团队由诺贝尔奖得主 David Gross 带队。
数学那项,一个专门的核查小组都没有。OpenAI 说联系过一位外部专家,对方建议直接把证明和 Lean 代码放出来,让大家自己决定怎么查。
三项结果,三种验法。OpenAI 在文章里也很坦率,说谁来挑第一批牧羊人,谁就决定了谁先参与,有些人会比别人更早知道更多,它自己也还不清楚三种办法里哪一种最好。
我其实挺尊重这个态度的。但你也看得出来,造出东西的这一方,已经开始为找不到够格的质检员发愁了。
那很多人会问,不是有 Lean 吗,机器检查不就完了?
坦率的讲,我之前也是这么想的。
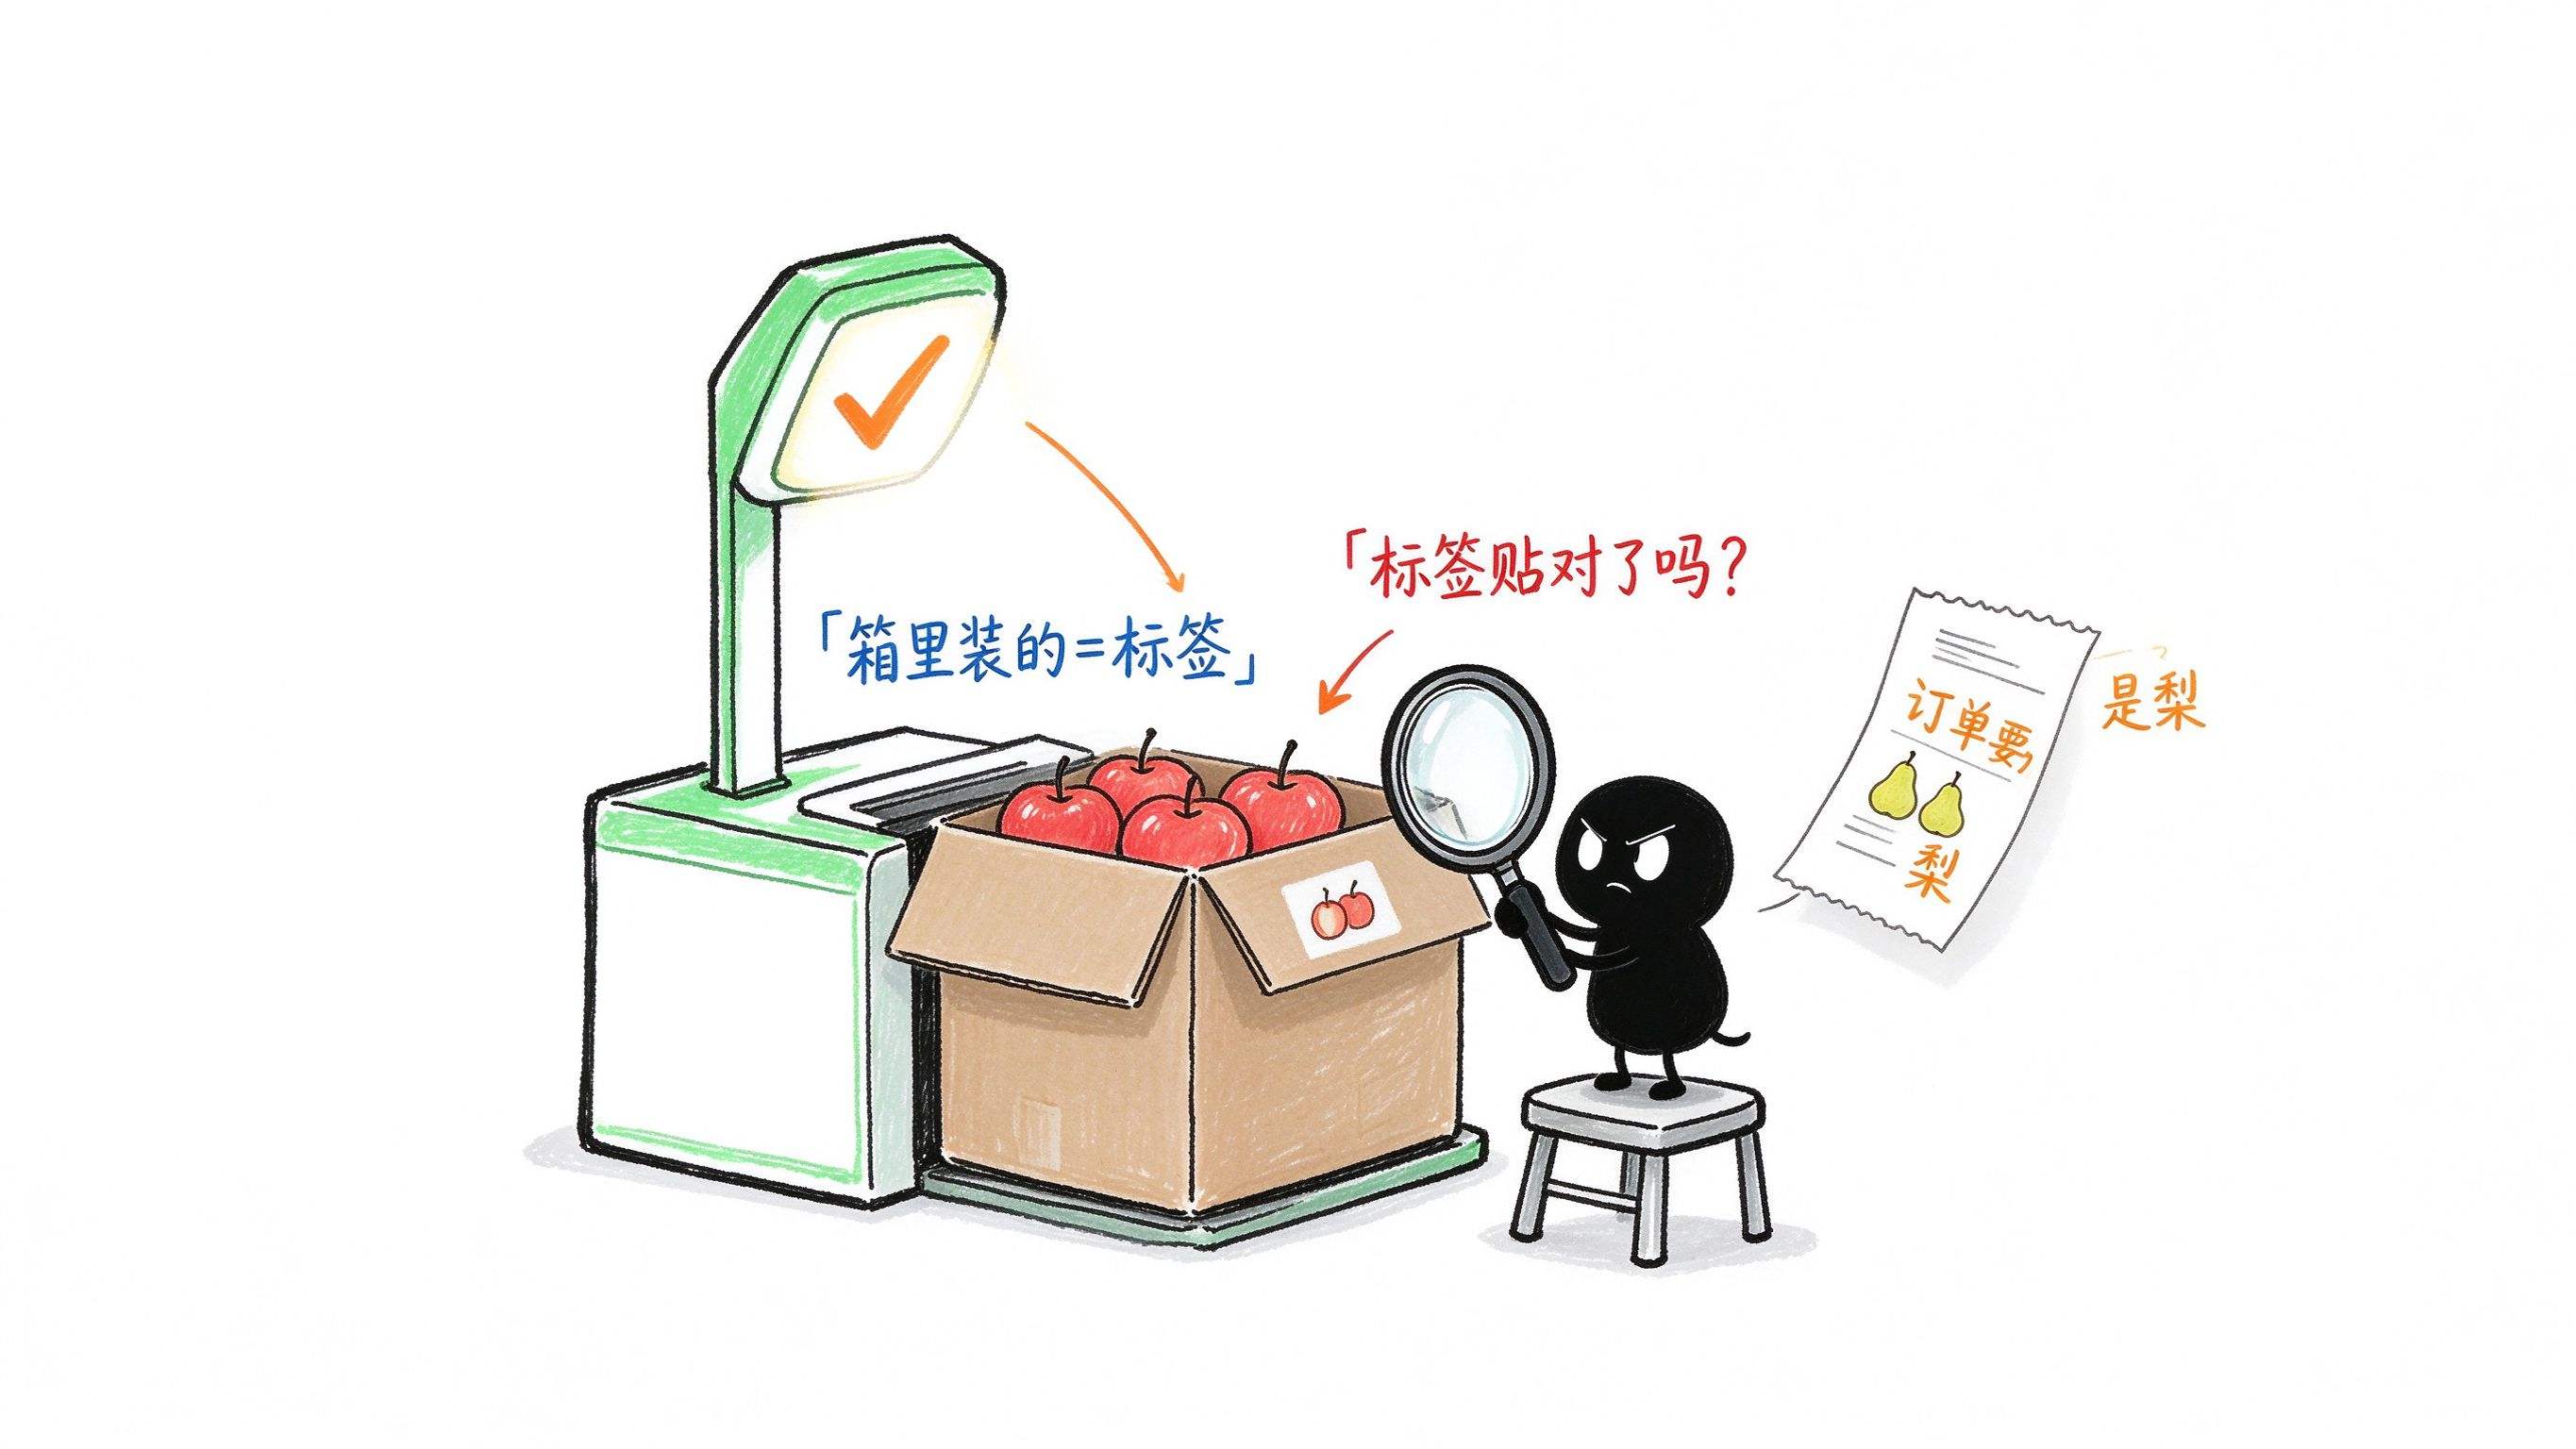
Lean 确实厉害,每一步推导它都核,错一步都过不去。可它有个经常被忽略的盲区,Lean 只检查证明是不是证明了你写进去的那个命题,至于这个命题是不是你真正想证的那个问题,它不管。
就好像一台验货机,它能确认箱子里装的就是标签上写的东西,一颗不多一颗不少。但标签是不是贴对了,它看不出来。
Axiom 那份长长的项目复盘里,最让我反复看的就是这一块。
项目早期,有些看着好处理的里程碑底下藏着巨大的前置工作,智能体没去证,直接当成了已知条件,结果几万行代码被删掉重来。后来反复出现的难题是,给定理加一条假设,到底是把活往后挪了,还是把定理的意思改了。多加几条没证过的假设,结论照样能推出来,看着完工了,其实原来的里程碑根本没完成。所以必须有人拿证出来的命题和原本的目标一条一条比对。
这活谁干?人。
还有一个细节特别好笑,又特别真实。项目越做越大,原话是智能体写证明的速度,比 Lean 重新检查它们的速度还快。**连机器质检员都被机器产线甩在后面了。**工程师只好专门搭了一套缓存和并行检查的系统,才把速度提上去。
那这一番折腾,验出了什么呢?
大部分是小毛病,错别字,表格写错,漏写的前提条件。但也有 34 处需要认真处理的偏差,最大的一处出在 Unbalanced Group Theorem,非平衡群定理。智能体在 John Walter 1986 年的论证里找到了明确的反例,一个被当成理所当然的封闭性论断不成立。定理本身没被推翻,但中间那一步的依据没了。
补这个洞时,Axiom 请来了当年参与分类定理的群论学家 Richard Lyons 和 Ronald Solomon。Solomon 1976 年的一套理论成了替代论证的核心,AxiomProver 在这基础上证出一个新的群论结果,把路重新接通。
你看,最后拍板这条路能不能走的,还是那几位老行家。
顺手说一句,分类定理的历史本身就是一部质检史。1983 年有人宣布分类完成,后来发现宣布早了,有个洞一直到 2004 年才用一套 1221 页的专著补上。人类自己写的 15000 页,用了二十多年才敢说基本核清楚。
讲到这,你可能会觉得出路很明显了,让 AI 去核 AI 嘛,Axiom 不就是这么干的。
Ai2 这篇论文就是来泼冷水的。
它测的是一个越来越常见的场景。现在很多 AI 科研系统会自动生成研究想法,然后再让另一个大模型当裁判,判断这个想法新不新。Ai2 测了六个裁判,GPT-5.1、GPT-5.2、GPT-5.4、Claude Sonnet 4.5、Claude Opus 4.5、Claude Opus 4.6。
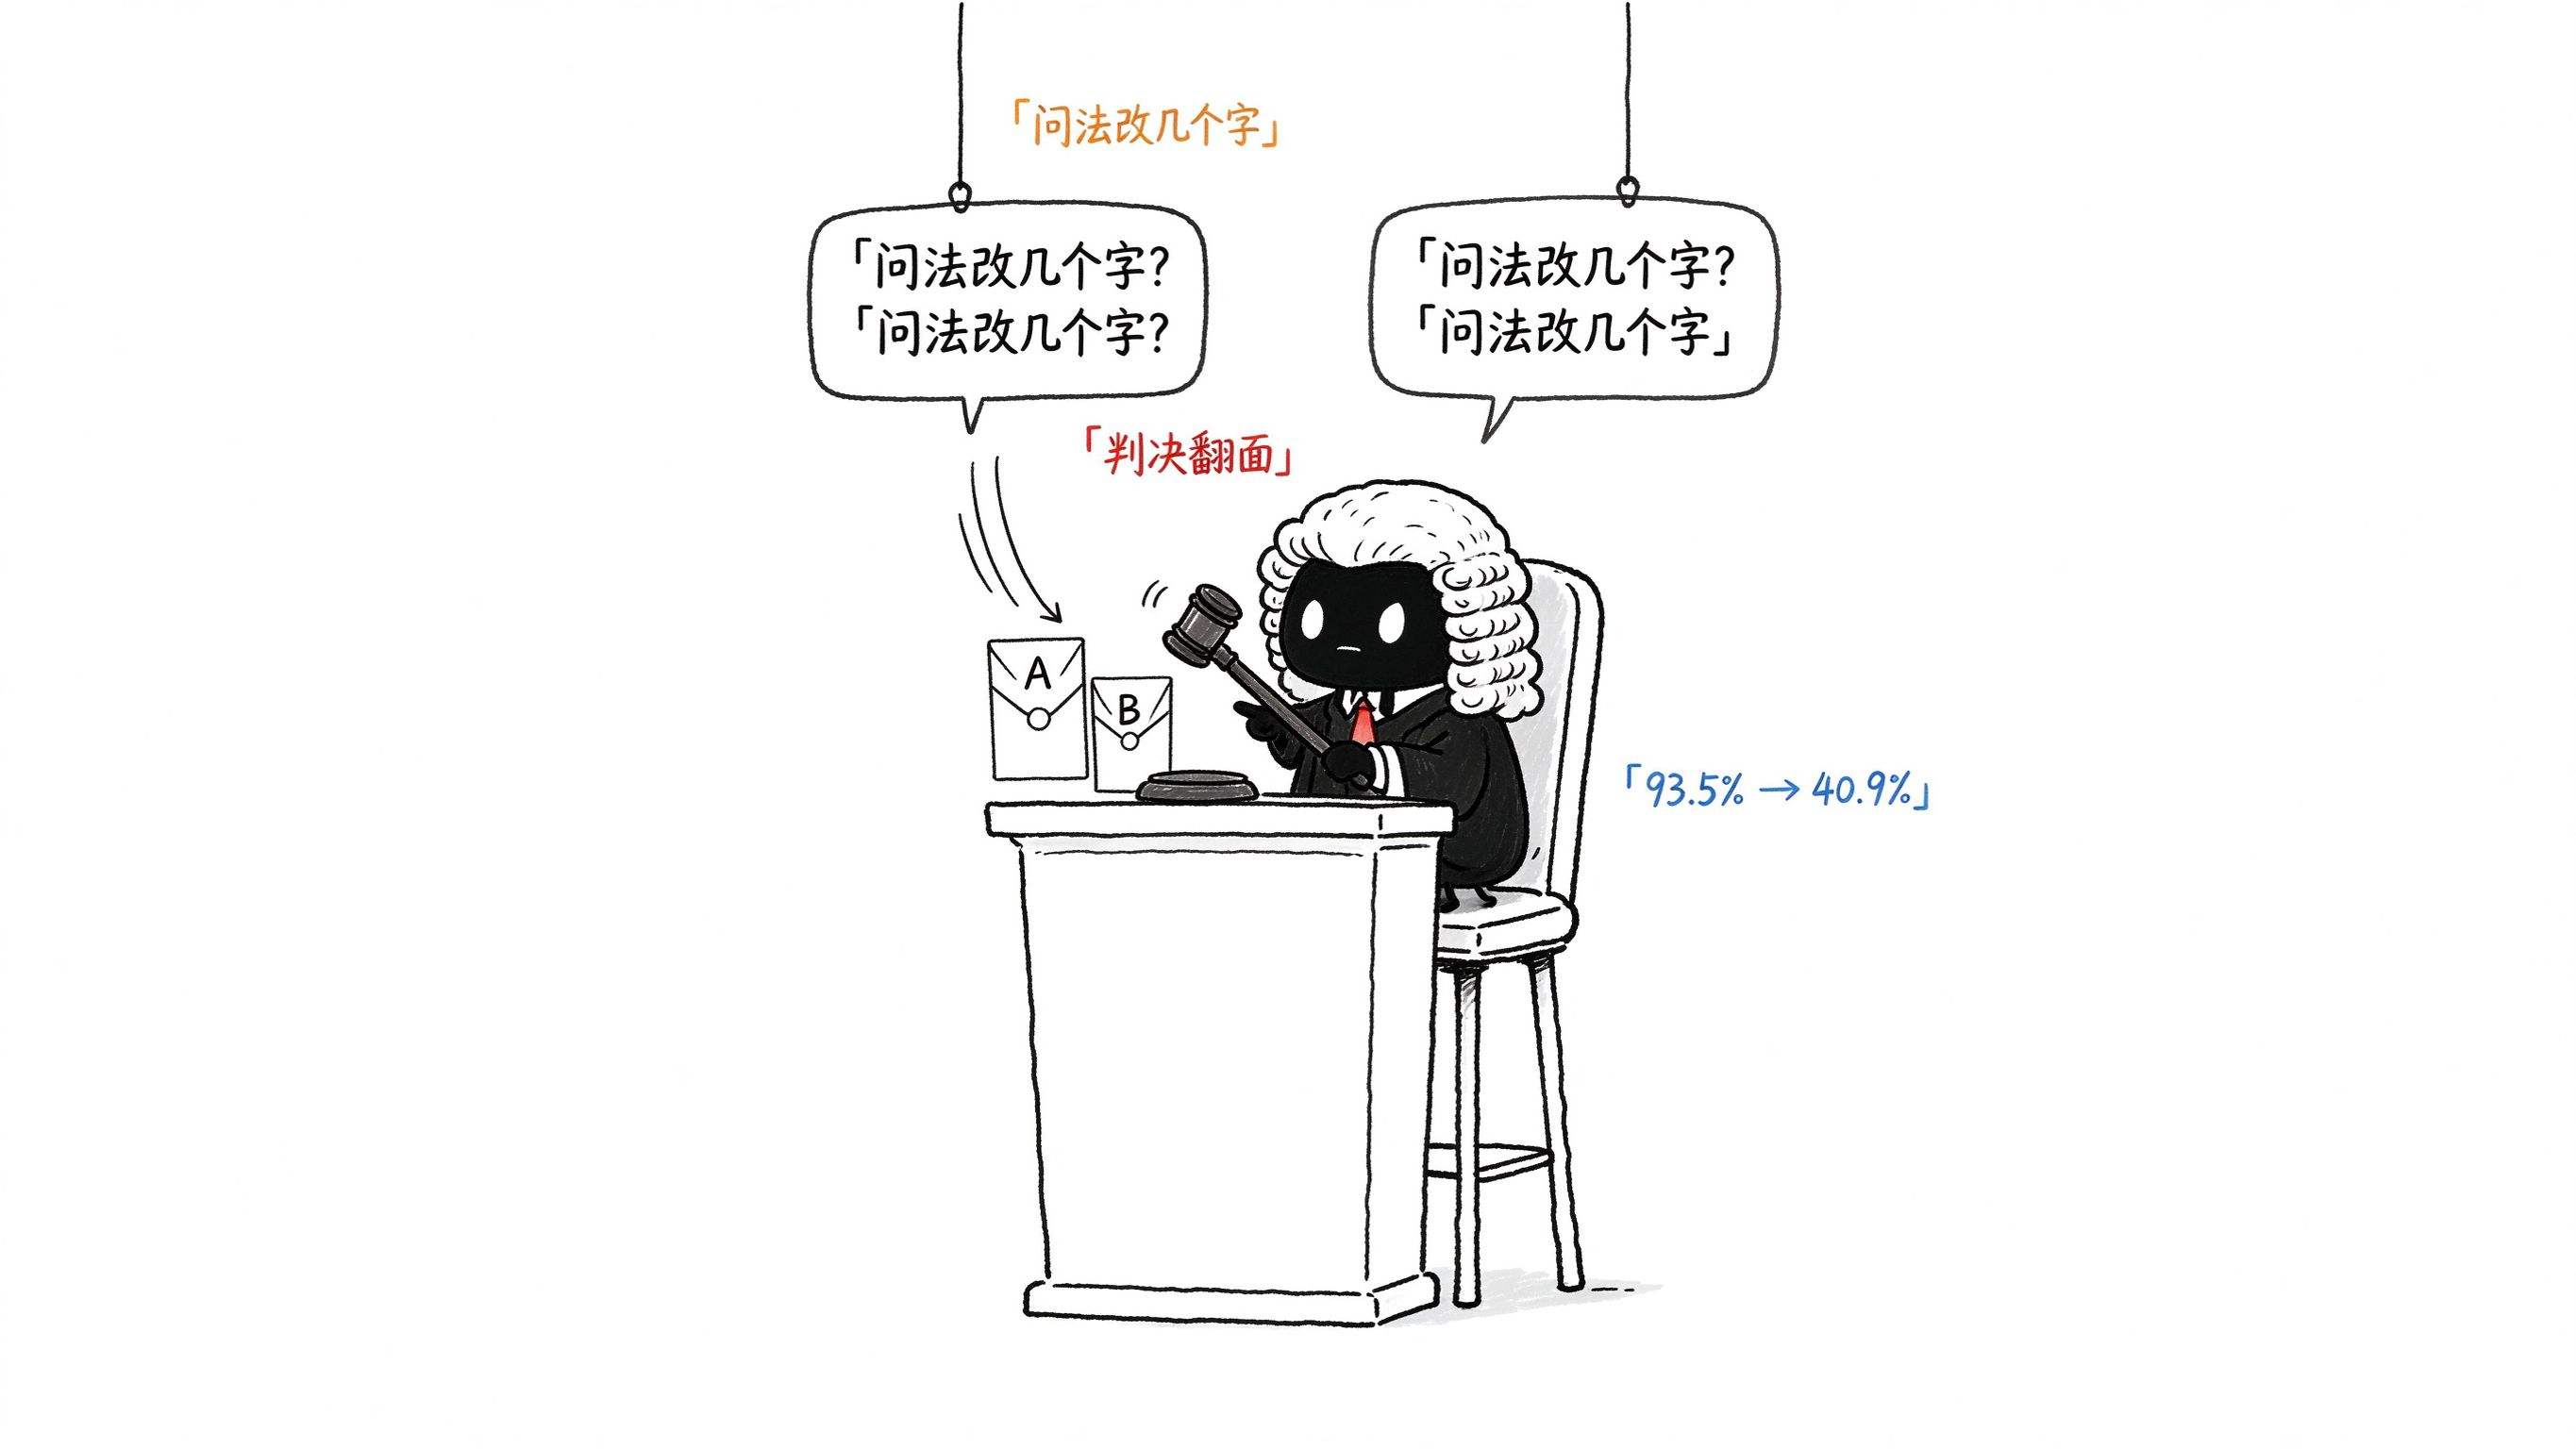
他们拿 GPT-5.4 做了一个实验。每组两个想法,一个来自 ICLR 2026 评分前 10%、评审明确夸过新颖的人类论文,另一个是简单让模型生成的。第一种问法告诉它,评审认为每组里恰好有一个是新的,请找出来。第二种问法只问,哪个想法是新的。
就改了这么几个字,准确率从 93.5% 掉到 40.9%,比瞎猜还低,同一批题目里超过一半的判断翻了个面。
看到这个数,我第一反应是,这剧情我见过。
10 月 16 号那篇我写过 ARC-AGI-3,同一个模型,换一套测试框架,分数从 49.8% 跳到 97.5%。当时我说跑分是玩具,现在回旋镖飞回来了,被测的那个会看框架脸色,当裁判的那个,也会看提示词脸色。
而且还有一层更扎心的。同样的提示词改动,换到纯人类想法的那组题上,准确率只差了大概 7 个点。裁判在人类写的东西上看着挺稳,一碰到 AI 生成的东西就开始飘,偏偏它被请来,就是为了审 AI 生成的东西。
那给裁判加搜索,加推理呢?Ai2 给 GPT-5.6 Sol 开了超高推理,让它在 arXiv 上反复检索,结果比一句简单提示的 Claude Opus 4.6 还低 11 个点,成本却高了大约 10 倍。两个专门做新颖性评估的系统,花了 30 到 82 美元,也没打过总共只花 2.59 美元的 Opus 4.6 基线。
也不能冤枉 AI 裁判。Ai2 自己也说,人类想法那组的标签是有依据的,AI 想法那组用的是弱标签。但论文里有一句话我很认同,两套都说得过去的评估设置,对同一对想法给出相反的答案,这种分歧本身,就已经说明了不稳定,跟标签对不对没关系。
我知道会有朋友不服气。人类审稿不也一样看心情吗,顶会审稿的随机性早就被吐槽烂了。这个我非常理解,人类质检员确实也不完美。但人类审稿慢,慢到错误有时间被别人发现,分类定理那个洞,就是被慢慢翻出来的。AI 裁判快,快到它晃一下,几万个结论跟着一起晃。
把这三件事摆在一块儿看,我反而想起昨天写的那篇。
Epoch 让 Claude 和 GPT 干自家研究员的活,最强的模型拿了 65 分,丢分几乎全丢在判断力上,其中有一个例子是 GPT 把自己实验里的 bug 当成研究发现写进了报告。当时我觉得,判断力是 AI 还没学会的那部分。
现在看,**判断力还是人得守住的最后一道工序。**AI 能出活,能把活翻成机器能核的格式,甚至能帮着核一部分,但这个命题是不是原来那个问题,这条假设是不是偷偷改了意思,这个裁判的结论是不是被问法带偏了,这几样,暂时还得有个懂行的人坐在那,看一眼,签个字。
说到签字,我想起金银器上的那个小印记。英语里有个词叫 hallmark,现在被用来指一个东西的标志性特征,它最早的意思,是伦敦金匠公会大厅打在金银器上的验印。几百年前,金匠做得再好,东西也得送到公会大厅,验过成色,打上这个印,才能拿出去卖。
金匠可以有一万个,打印的那个大厅只有一个。
现在 AI 就像突然冒出来一万个手艺极好、偶尔会往银子里掺点东西的金匠,而那个大厅里,还是 Impagliazzo、Paturi、Lyons、Solomon 这几位在这行干了几十年的老行家。OpenAI 在想办法多请几位,Axiom 在给大厅装更快的机器,Ai2 在提醒大家,先别急着让金匠给自己打印。
说实话我也不确定这个局面会怎么解。也许过几年 Lean 这类工具能把标签贴错的问题也管起来,也许会长出一批专门干验收这件事的新职业。但至少眼下,我会对所有 AI 刚刚证明了某某某的标题多停一秒,先问一句,谁验的,打印了吗。
谢谢你看我的文章,我们,下次再见。
/ 作者:青玉白露
评论区
欢迎留下你的看法,支持匿名评论。
你的评论会公开展示,建议填写便于交流的昵称,并尽量提供有信息量的反馈。