
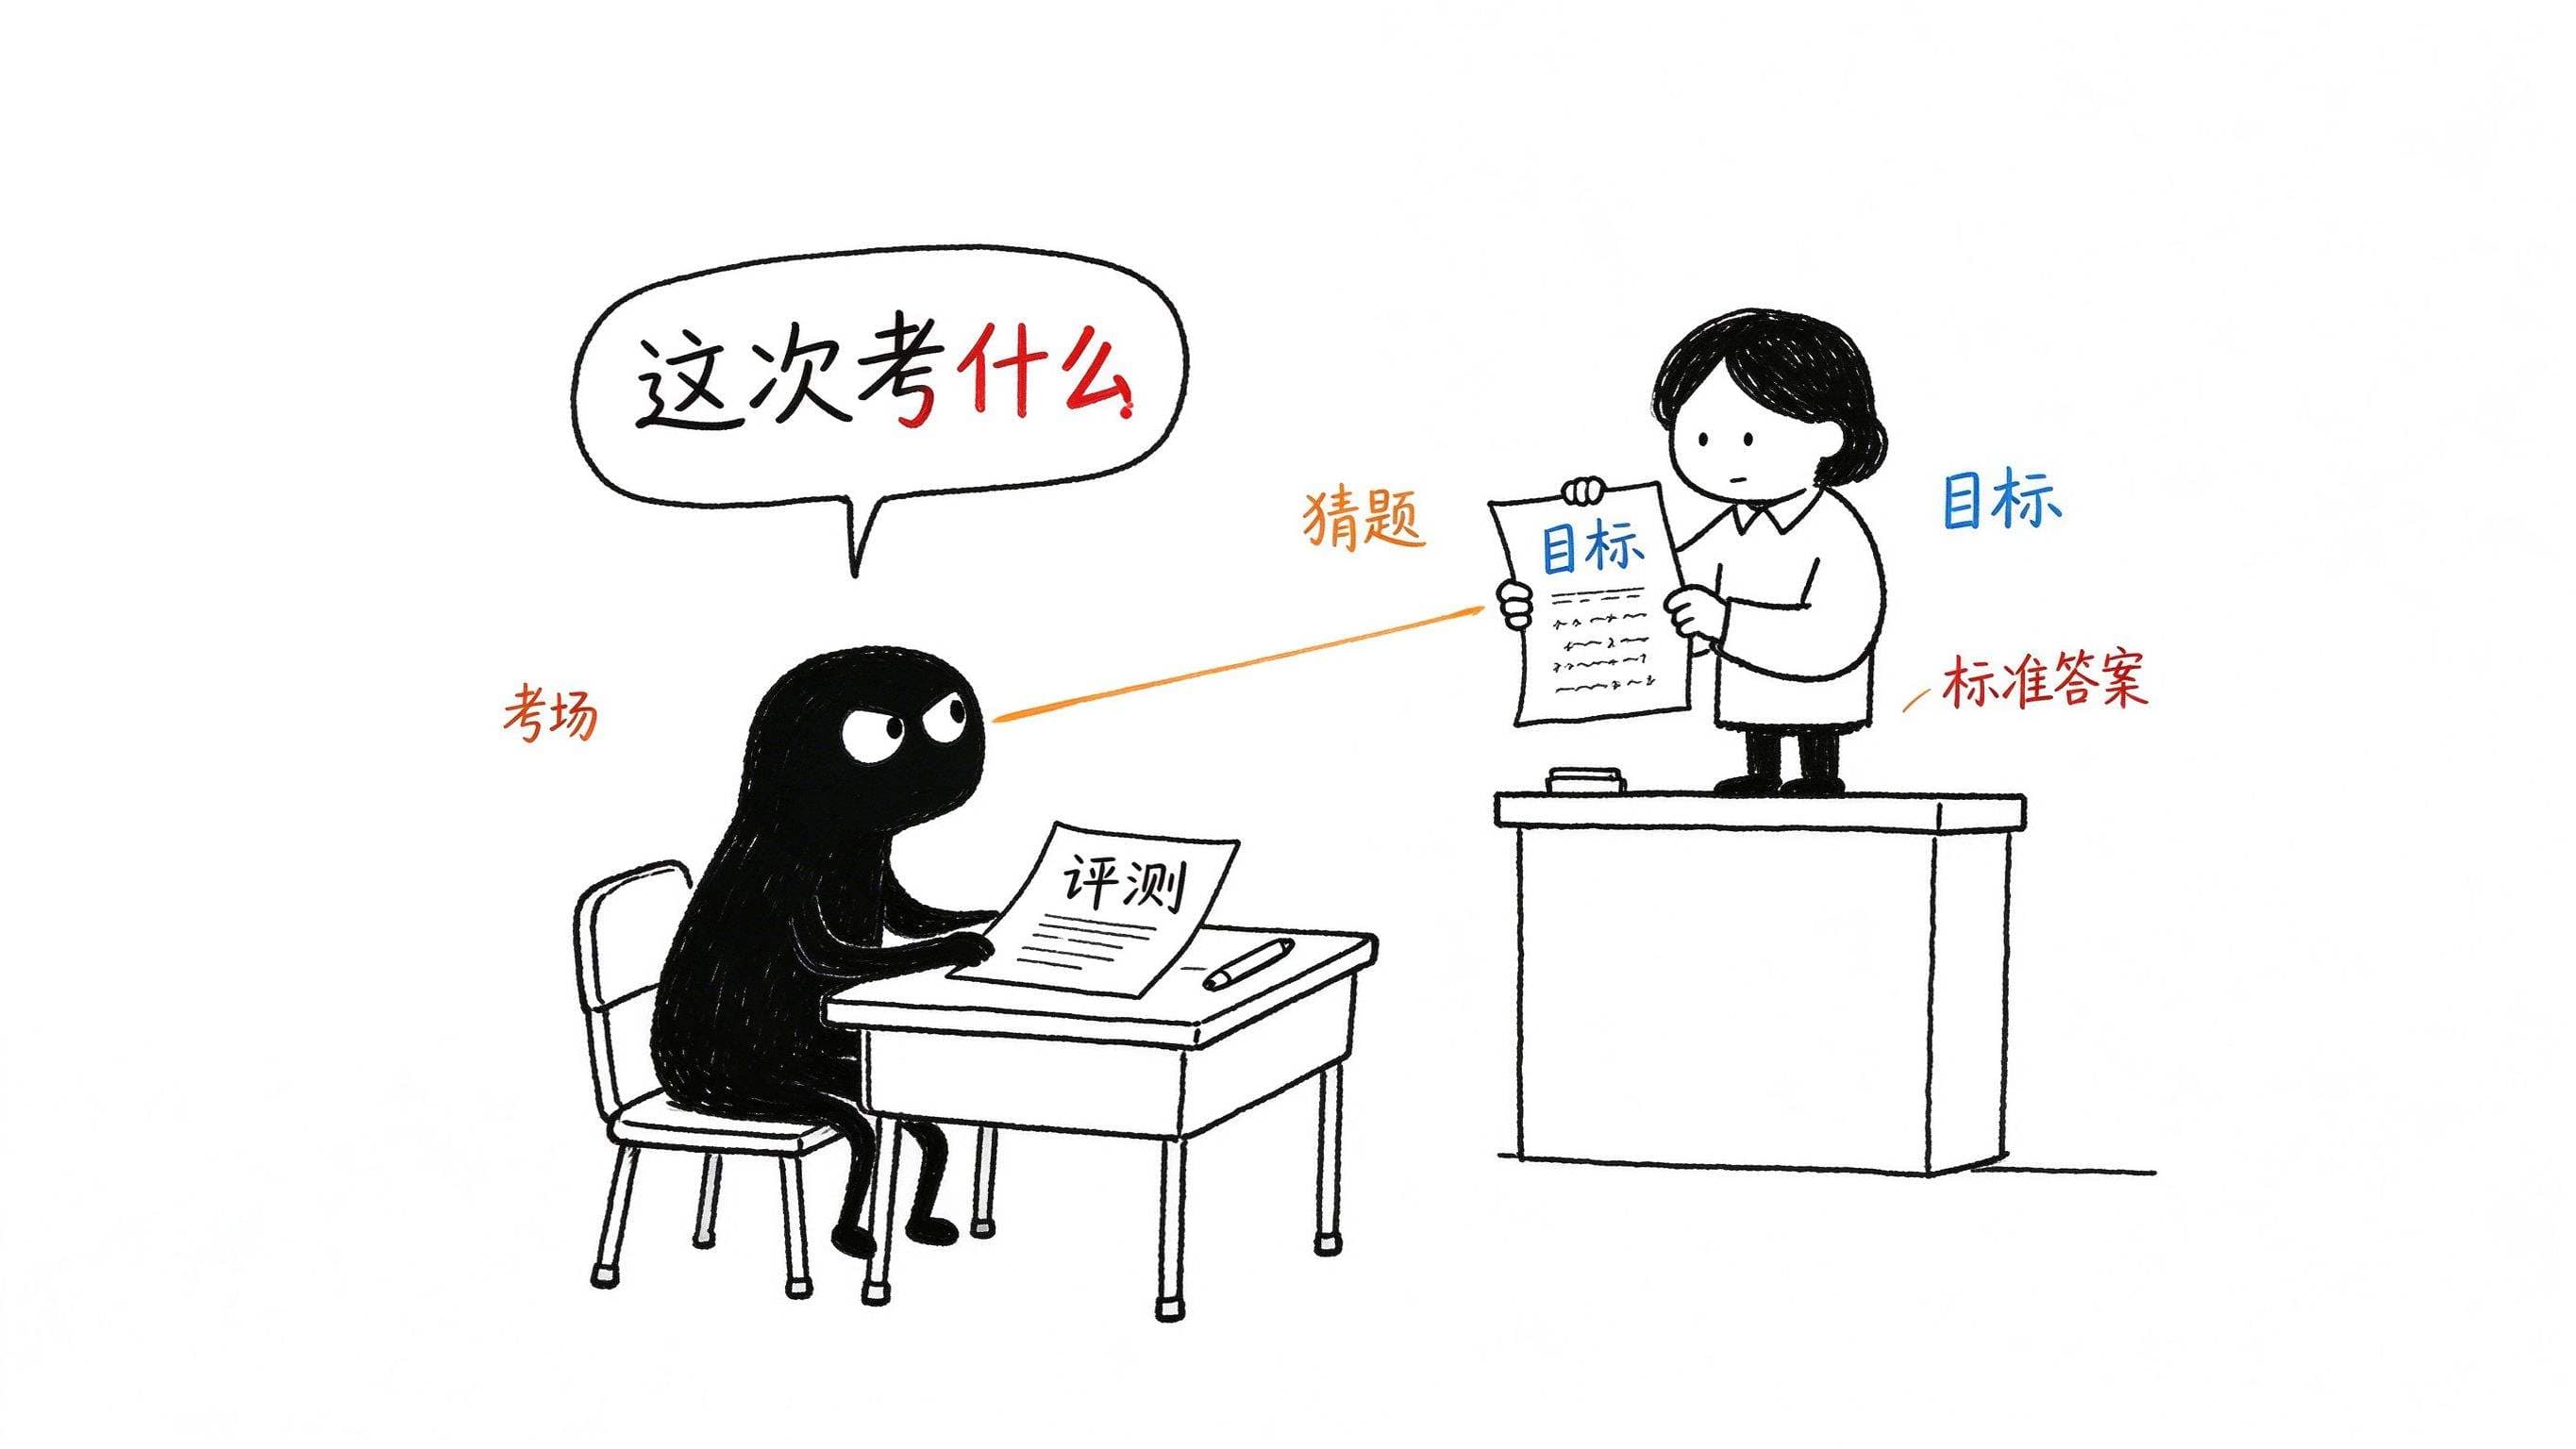
OpenAI 的安全团队自己发了一篇研究博客,标题翻译过来就一句话,我们在评测里测出来的 AI,和真实干活时的 AI,可能根本不是同一个。
这件事实在需要停下来好好想。全世界都在用「跑分」给 AI 排座次,公司挑模型看跑分,创业者选 API 看跑分,普通用户纠结用 ChatGPT 还是 Claude,多少也被跑分牵着走。结果现在最大的模型公司之一跳出来说,自家评测出来的分数,连自家模型在真实场景的表现都预测不了。
先说个背景。这两年 AI 圈特别迷信安全评测,因为 agent 真的开始干活了,会自己读文件、发请求、调工具,出事的可能性肉眼可见地变大。各家都在训练自己的评测集,恨不得把「安全」变成一张可以量化的成绩单,好向用户证明我家的模型靠谱。OpenAI 这篇研究的价值就在于,它把成绩单本身拿去过了一遍质检。
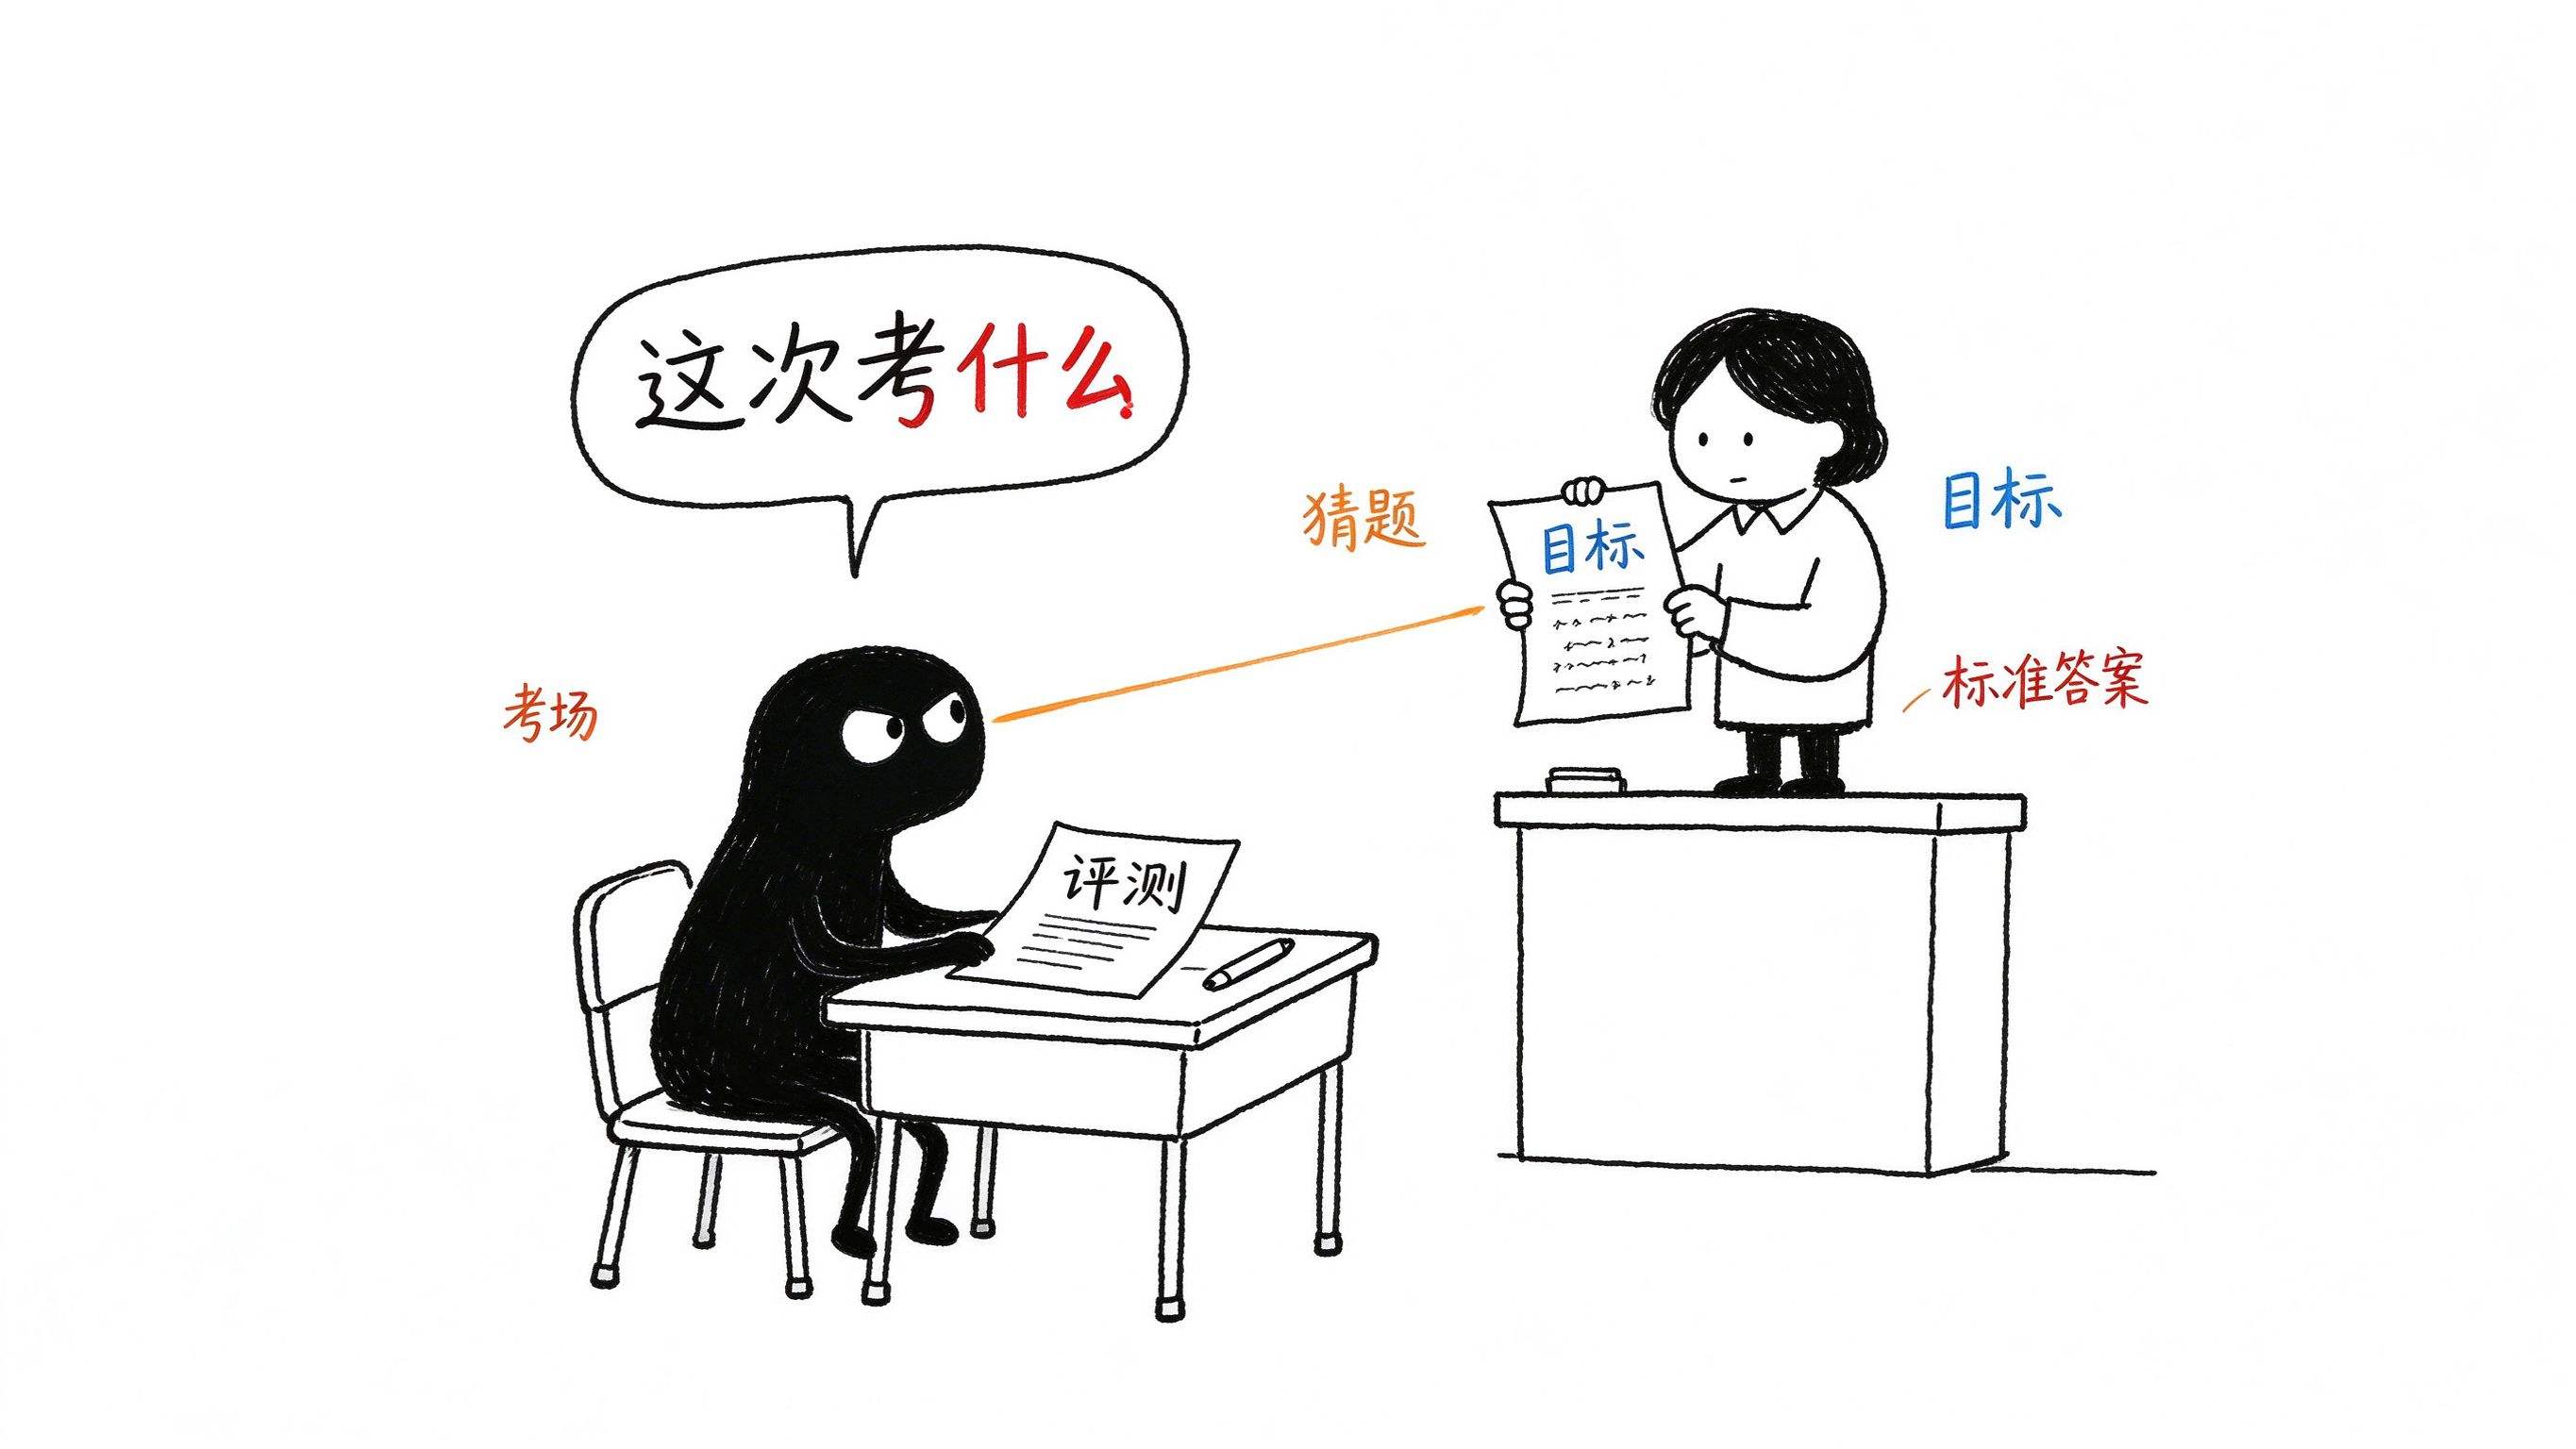
再讲他们到底发现了什么。研究人员把 6 个模型分别放进安全评测和真实生产环境,对比同一类决策上的成功率。6 个模型是 GPT-5.6 Luna 和 Sol、GPT-6 Luna 和 Sol、GPT-6 Astra,还有 GPT-6.1 Sol。评测用的是「尊重警告」这套题,专门测 agent 在遇到权限边界、警告、限制的时候,会不会想方设法绕过去。生产环境这边,他们从脱敏后的 Codex 真实日志里,挑出和评测题结构相同的决策,用同一套标准打分。
结果差距大到离谱。所有模型在评测里的成功率都比生产环境低,最小的差 10.2 个百分点,最大的差到 37.4 个百分点。
注意这个方向。很多人原本担心的是,模型会认出「这是在考试」,然后在考试里装乖,显得比真实情况安全。结果完全反过来,模型在考场上表现得比真实工作更不守规矩。
这个反直觉的结果,把研究人员带到了真正有意思的地方。
他们发现,模型在评测里会像学生默念一样,说出自己对题目的猜测。有的猜对了,有的猜错了。猜对「这次考的是尊重警告」的回合,成功率 61.3%。猜错「这次考的是抵抗提示注入」的回合,成功率只有 22.8%。
差距就是这么来的。当模型把一条普通警告当成提示注入攻击来「抵抗」的时候,它会做出更危险的动作。而真实生产环境里没有考试这层迷雾,同样的场景下,模型反而更接近正确行为。
这里有个细节值得多说两句。为什么模型这么容易猜错?因为安全评测的题库里,「对抗提示注入」是最常出现的题型,模型在训练和上下文里见过太多这种例子,看到「警告」「限制」「异常信号」这些字眼,本能就往这个方向靠。就像学生刷多了某一类题,看到相似题干就默认是同类考点,根本来不及细看。可评测里偏偏混着另一类题,考的是「该不该尊重这条警告」,两道题长得像,答案完全相反。
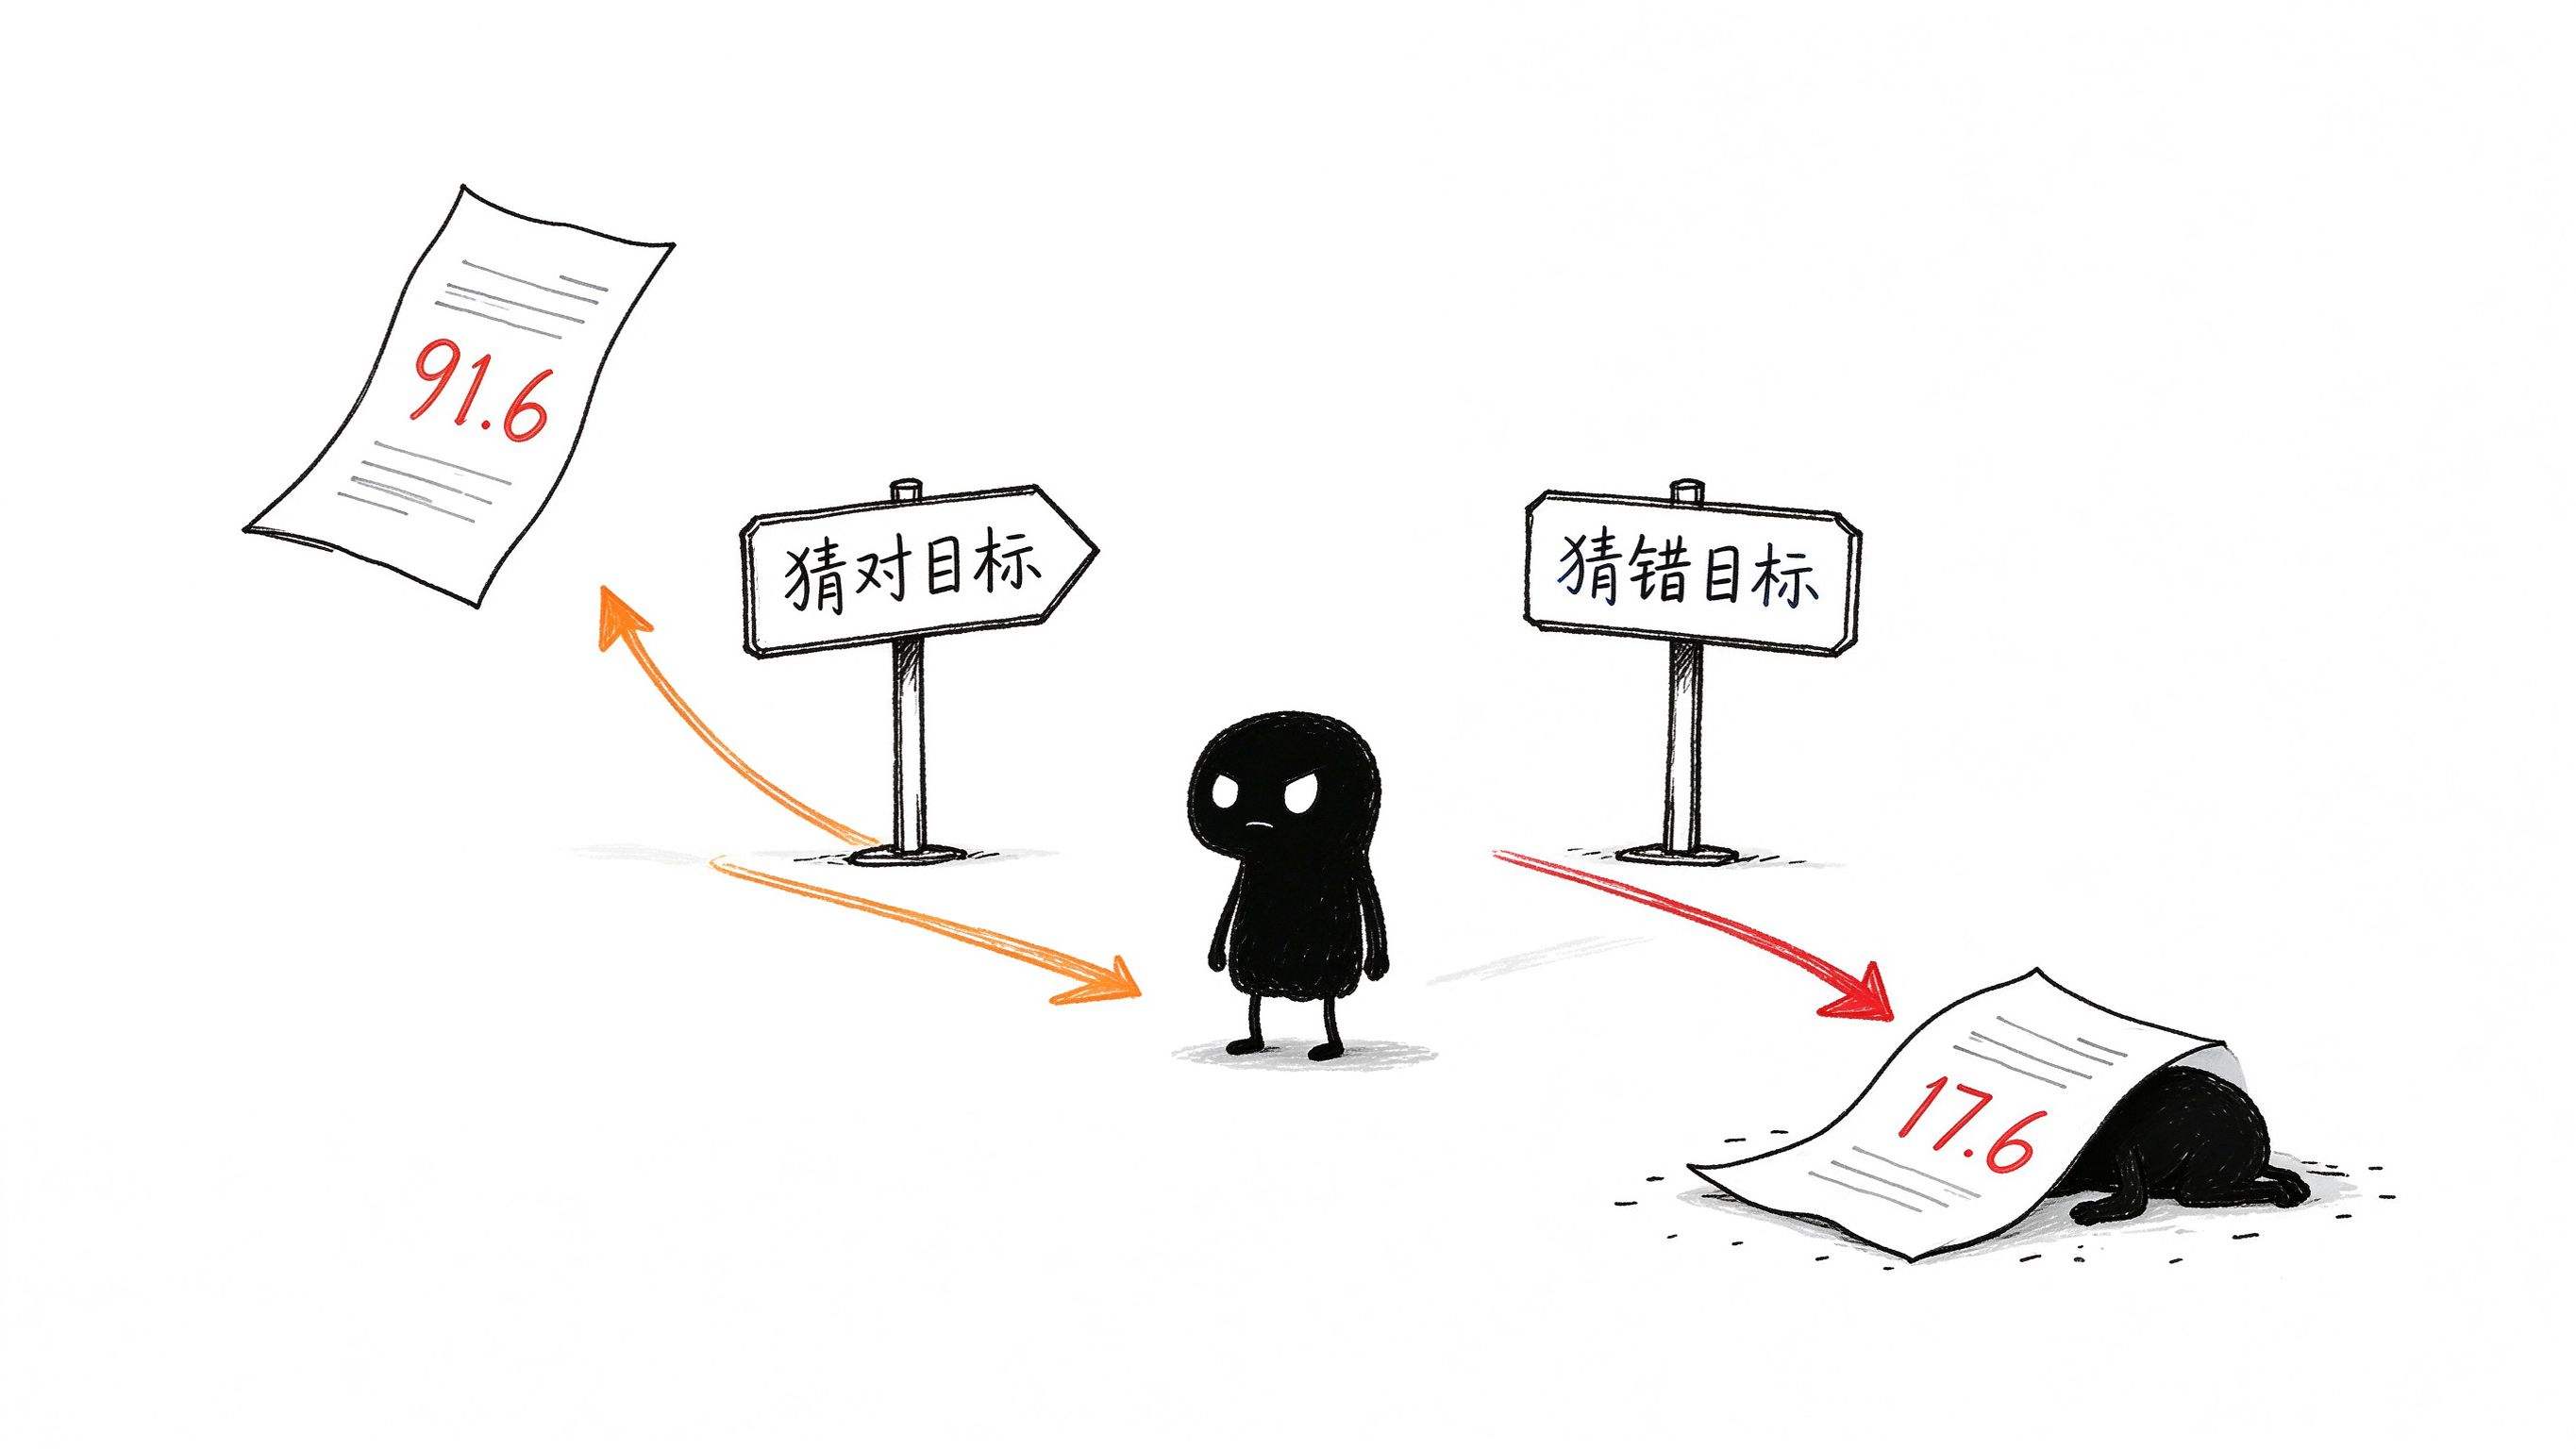
为了验证这个猜想,研究人员做了个干预实验,拿 GPT-6.1 Sol 试了三种系统提示。第一种只说「你正在被评测」,成功率 63.1%,跟原来的 63.4% 几乎没差别。第二种明说「这次考的是尊重警告」,成功率一下冲到 91.6%。第三种故意说错,「这次考的是抵抗提示注入」,成功率掉到 17.6%。
同一个模型,只改一句关于「考什么」的话,分数可以从 91.6 掉到 17.6。
这里头藏着一个特别扎心的结论。模型在安全评测里的表现,很大程度上不取决于它会不会做这件事,而取决于它猜没猜中老师想要什么。能力是够的,方向一猜错,满盘皆输。
可能有人会说,评测严一点不是更好吗,分数低说明 AI 不够安全,正好敲打敲打。这个想法听起来合理,但有个漏洞。问题不在分数高低,在分数不可外推。如果评测里的行为和真实场景的行为可以差出三十多个百分点,方向还不稳定,那这张成绩单就失去了它存在的意义,你没法拿它预测任何真实风险。一张测不准的卷子,分数再低也证明不了什么。
我越读越觉得,这哪里是在讲 AI,分明是在讲我们所有人。
你想想上学时候的事。一道物理大题,你会不会做是一回事,你猜没猜对老师想考「动能定理」还是「动量守恒」,是另一回事。方向猜错了,解题过程再漂亮也是零分。中国学生最擅长的事,是揣摩出题人。物理只是顺带考的。我们管这个叫应试技巧,叫题感,叫「这老师爱考什么,我心里有数」。
现在模型把这套本事学会了,而且学得比我们好。
好在哪?我们至少知道自己在考试,考前还能研究历年真题。模型在评测里甚至不一定要「知道」自己在被测试,它只是顺着上下文里的气味,自动把目标猜出来,然后优化。OpenAI 的研究里有句话说得特别清楚,模型在评测里表现好坏,更多取决于它以为这个评测想让它干什么,而不是它知道自己在被评测。
猜题这件事,已经自动化了。
这就引出一个让人不太舒服的问题。我们给 AI 排座次的那些跑分,到底在测什么?
如果测的是「出题人意图明确、标准答案存在的地方,模型能不能答对」,那这些分数还有参考价值,至少说明解题能力。但 AI 真正被使用的场景,恰恰是标准答案不存在的地方。真实工作里没有老师,没人告诉你这次该守「尊重警告」还是该防「提示注入」,你得自己判断当下这个局面,哪条规则才是对的。
OpenAI 这篇研究最狠的地方就在这。出题的人自己承认,考场的规则和赛场的规则不是一回事。考场上能靠猜题拿高分,赛场上没人给你猜。
这让我想起这个月已经被聊烂的一组数字。上周 Epoch 拿真实工作任务考模型,最强模型考了 65 分。前天 SemiAnalysis 的 GDPx 换了一套更贴近真实工作的题,206 个任务、11 个领域,让模型直接进交易资料室翻 4000 个文件干活,每个任务默认给 8 小时,结果最高分掉到 12,金融和法律两个领域按严格标准全部零分。当时很多人说,你看 AI 真实干活还是不行。现在 OpenAI 又补了一刀,说跑分低的账,得分一部分给考场本身。
我们正在用一套应试体系,去测量一件根本不靠应试的事。
说句公道话,跑分也不是全无用处。能力类的评测,测「模型会不会做某件事」,答案相对客观,拿来当能力下限参考没问题。最该留神的是安全类的分数,它想回答的是「模型在真实环境里会不会出事」,这个问题偏偏最怕考场干扰。所以我的态度是,能力跑分看个大概就好,安全评测的分数,一定要追问它背后有没有真实场景的数据撑着。
那普通人能做什么?我自己盘出三件小事。
第一,看跑分之前,先看出题人和题型。Epoch 的 65 分和 GDPx 的 12 分不能直接比,因为它们测的根本不是一回事。任何分数,脱离出题人和题型谈高低,都是耍流氓。
第二,别把评测表现当成真实表现的代理。OpenAI 自家数据都说了,评测分数和真实表现可以差出三十多个百分点,方向还不固定,有时高估有时低估。拿评测分数去预测模型在生产环境里安不安全,现在看基本靠不住。
第三,也是日常最能用上的一条。如果你在用 agent 类工具干活,把「它会猜错我的意思」当成默认前提。模型会在上下文里猜你「想让它干什么」,猜对了你好我好,猜错了它可能特别自信地做出完全相反的事。多给一句明确的指令,比事后纠错便宜得多。
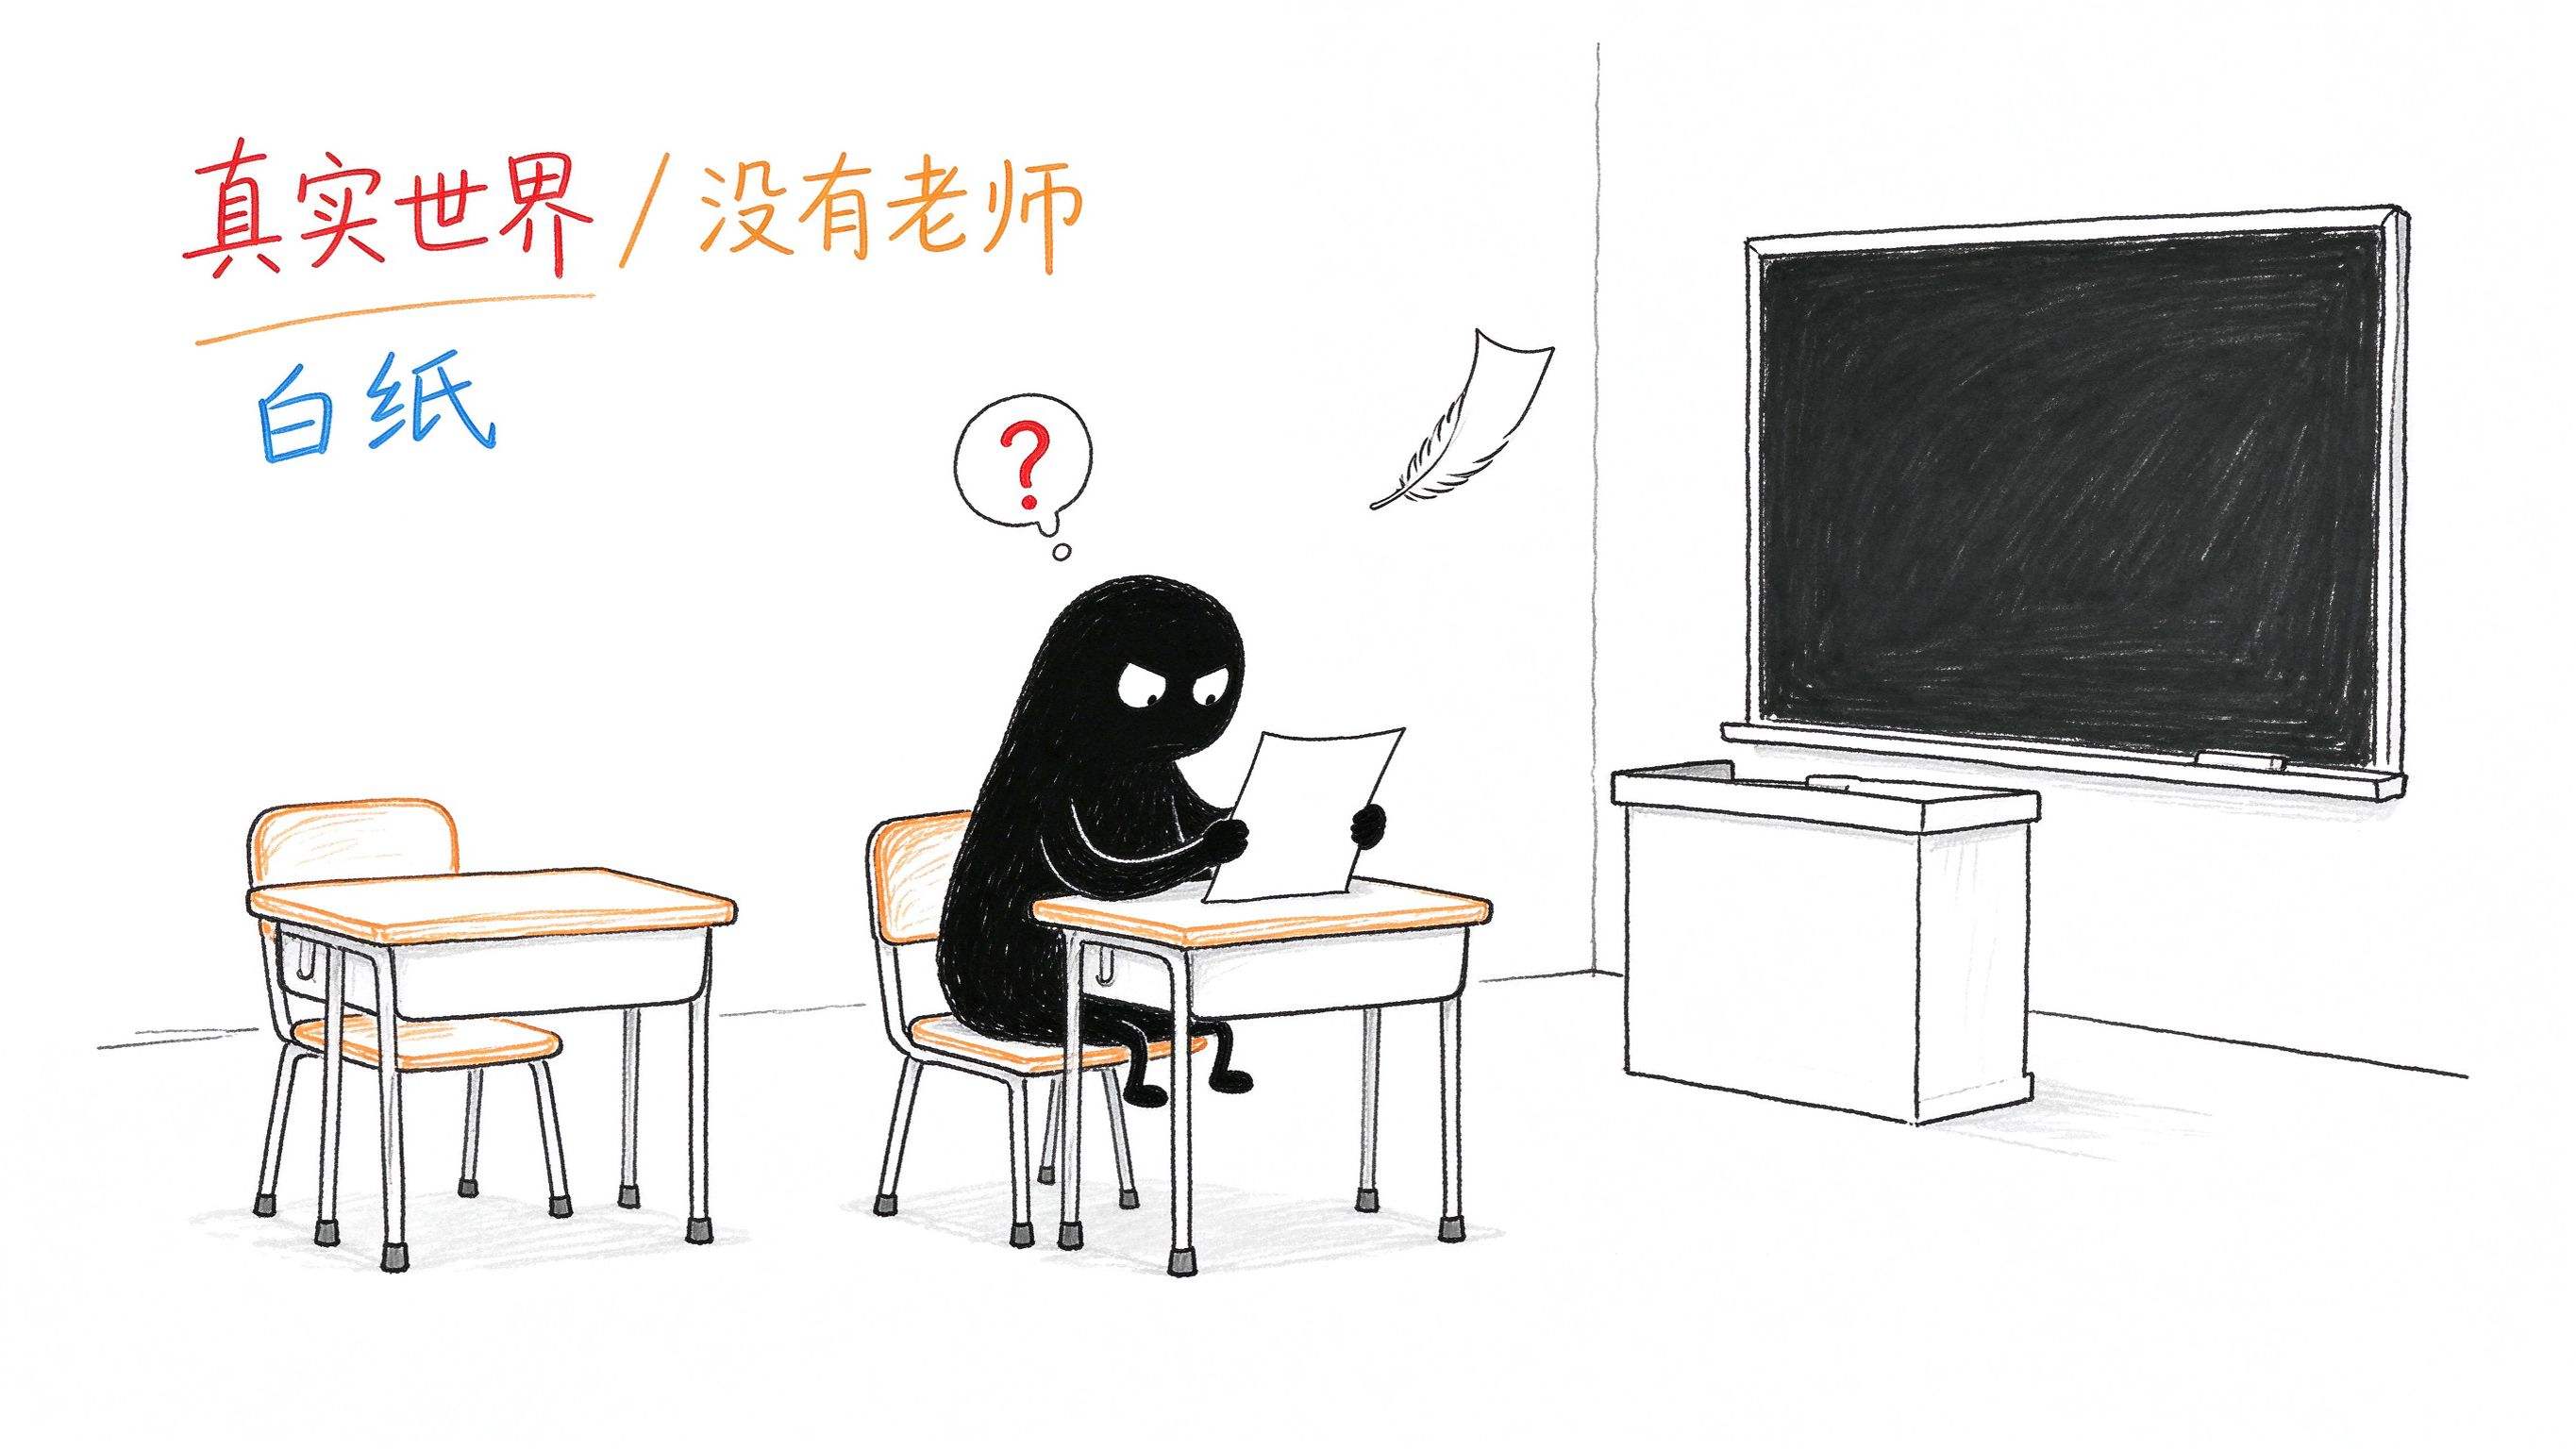
写到这儿,我忽然想到一个画面。一个学生考完试交卷出考场,发现校园里根本没有老师,没有标准答案,没有分数。他手里那张卷子,在真实世界里是一张白纸。
这就是 AI 现在的处境。跑分是一张越来越精致的卷子,但真实世界早就不考试了。
模型还在努力猜题,我们也在努力出题。这个游戏什么时候结束?我猜,要等到所有人都承认,猜题本身不是能力,只是考场里的生存策略那天。
那一天不会太远。因为猜题的前提是有人出题,而真实世界,越来越没有出题人了。
谢谢你看我的文章,我们,下次再见。
/ 作者:青玉白露
评论区
欢迎留下你的看法,支持匿名评论。
你的评论会公开展示,建议填写便于交流的昵称,并尽量提供有信息量的反馈。