
DeepSeek 在一篇技术文章里写了一个观察,一个人通常只能同时跟进 3 到 5 个活跃的 Agent 会话。
用过 Claude Code 或 Codex 多开窗口的人,大概都能想象那个画面。这个窗口在改登录页,那个窗口在跑测试,另一个在查线上报错。每切回一个窗口,都得先回忆它刚才干到哪了,上次让它干嘛来着。模型在那边干得挺快,卡住的是坐在屏幕前的人。
10 月 31 日晚上,DeepSeek Harness 团队发了这篇《Super-agent 设计探索》,想解决的就是这个问题。文章开头把话说得很直白,模型做单个任务越来越不需要人插手,限制生产力的东西,正在变成人的注意力。
AI 干活越来越快,最先不够用的是人的注意力。
他们给出的办法,我读完第一反应是,这不就是一家餐馆嘛。
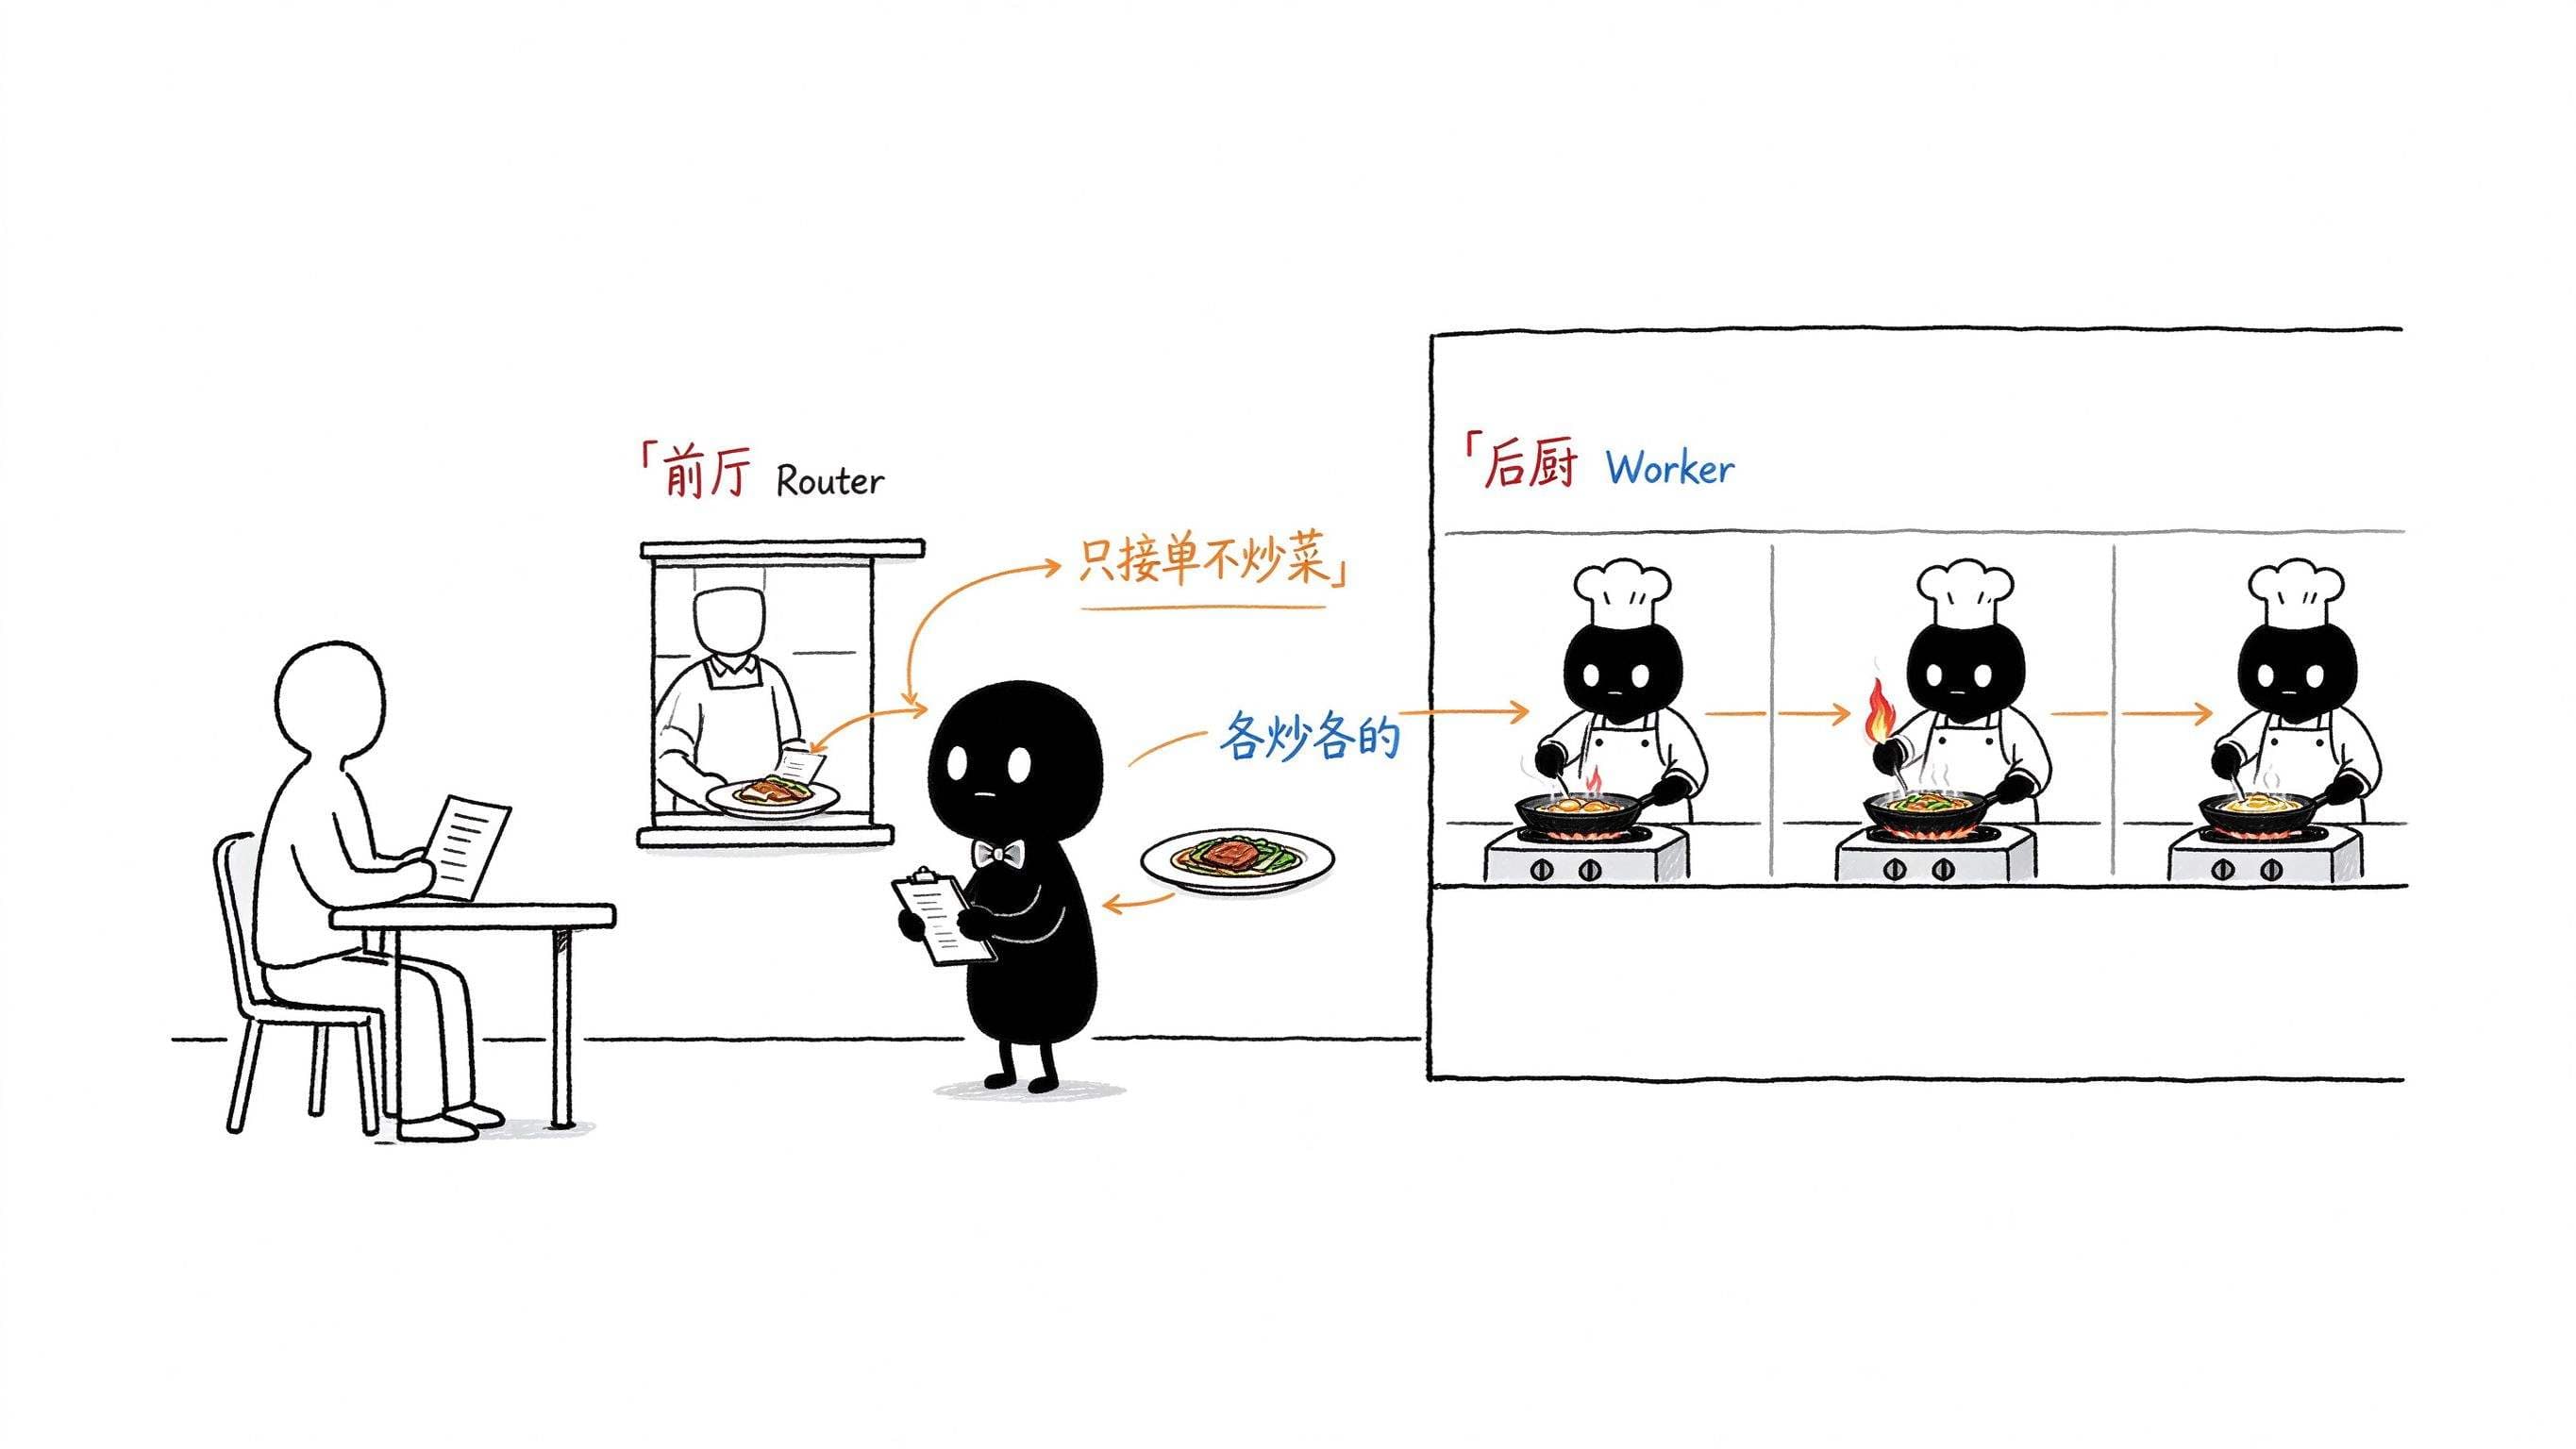
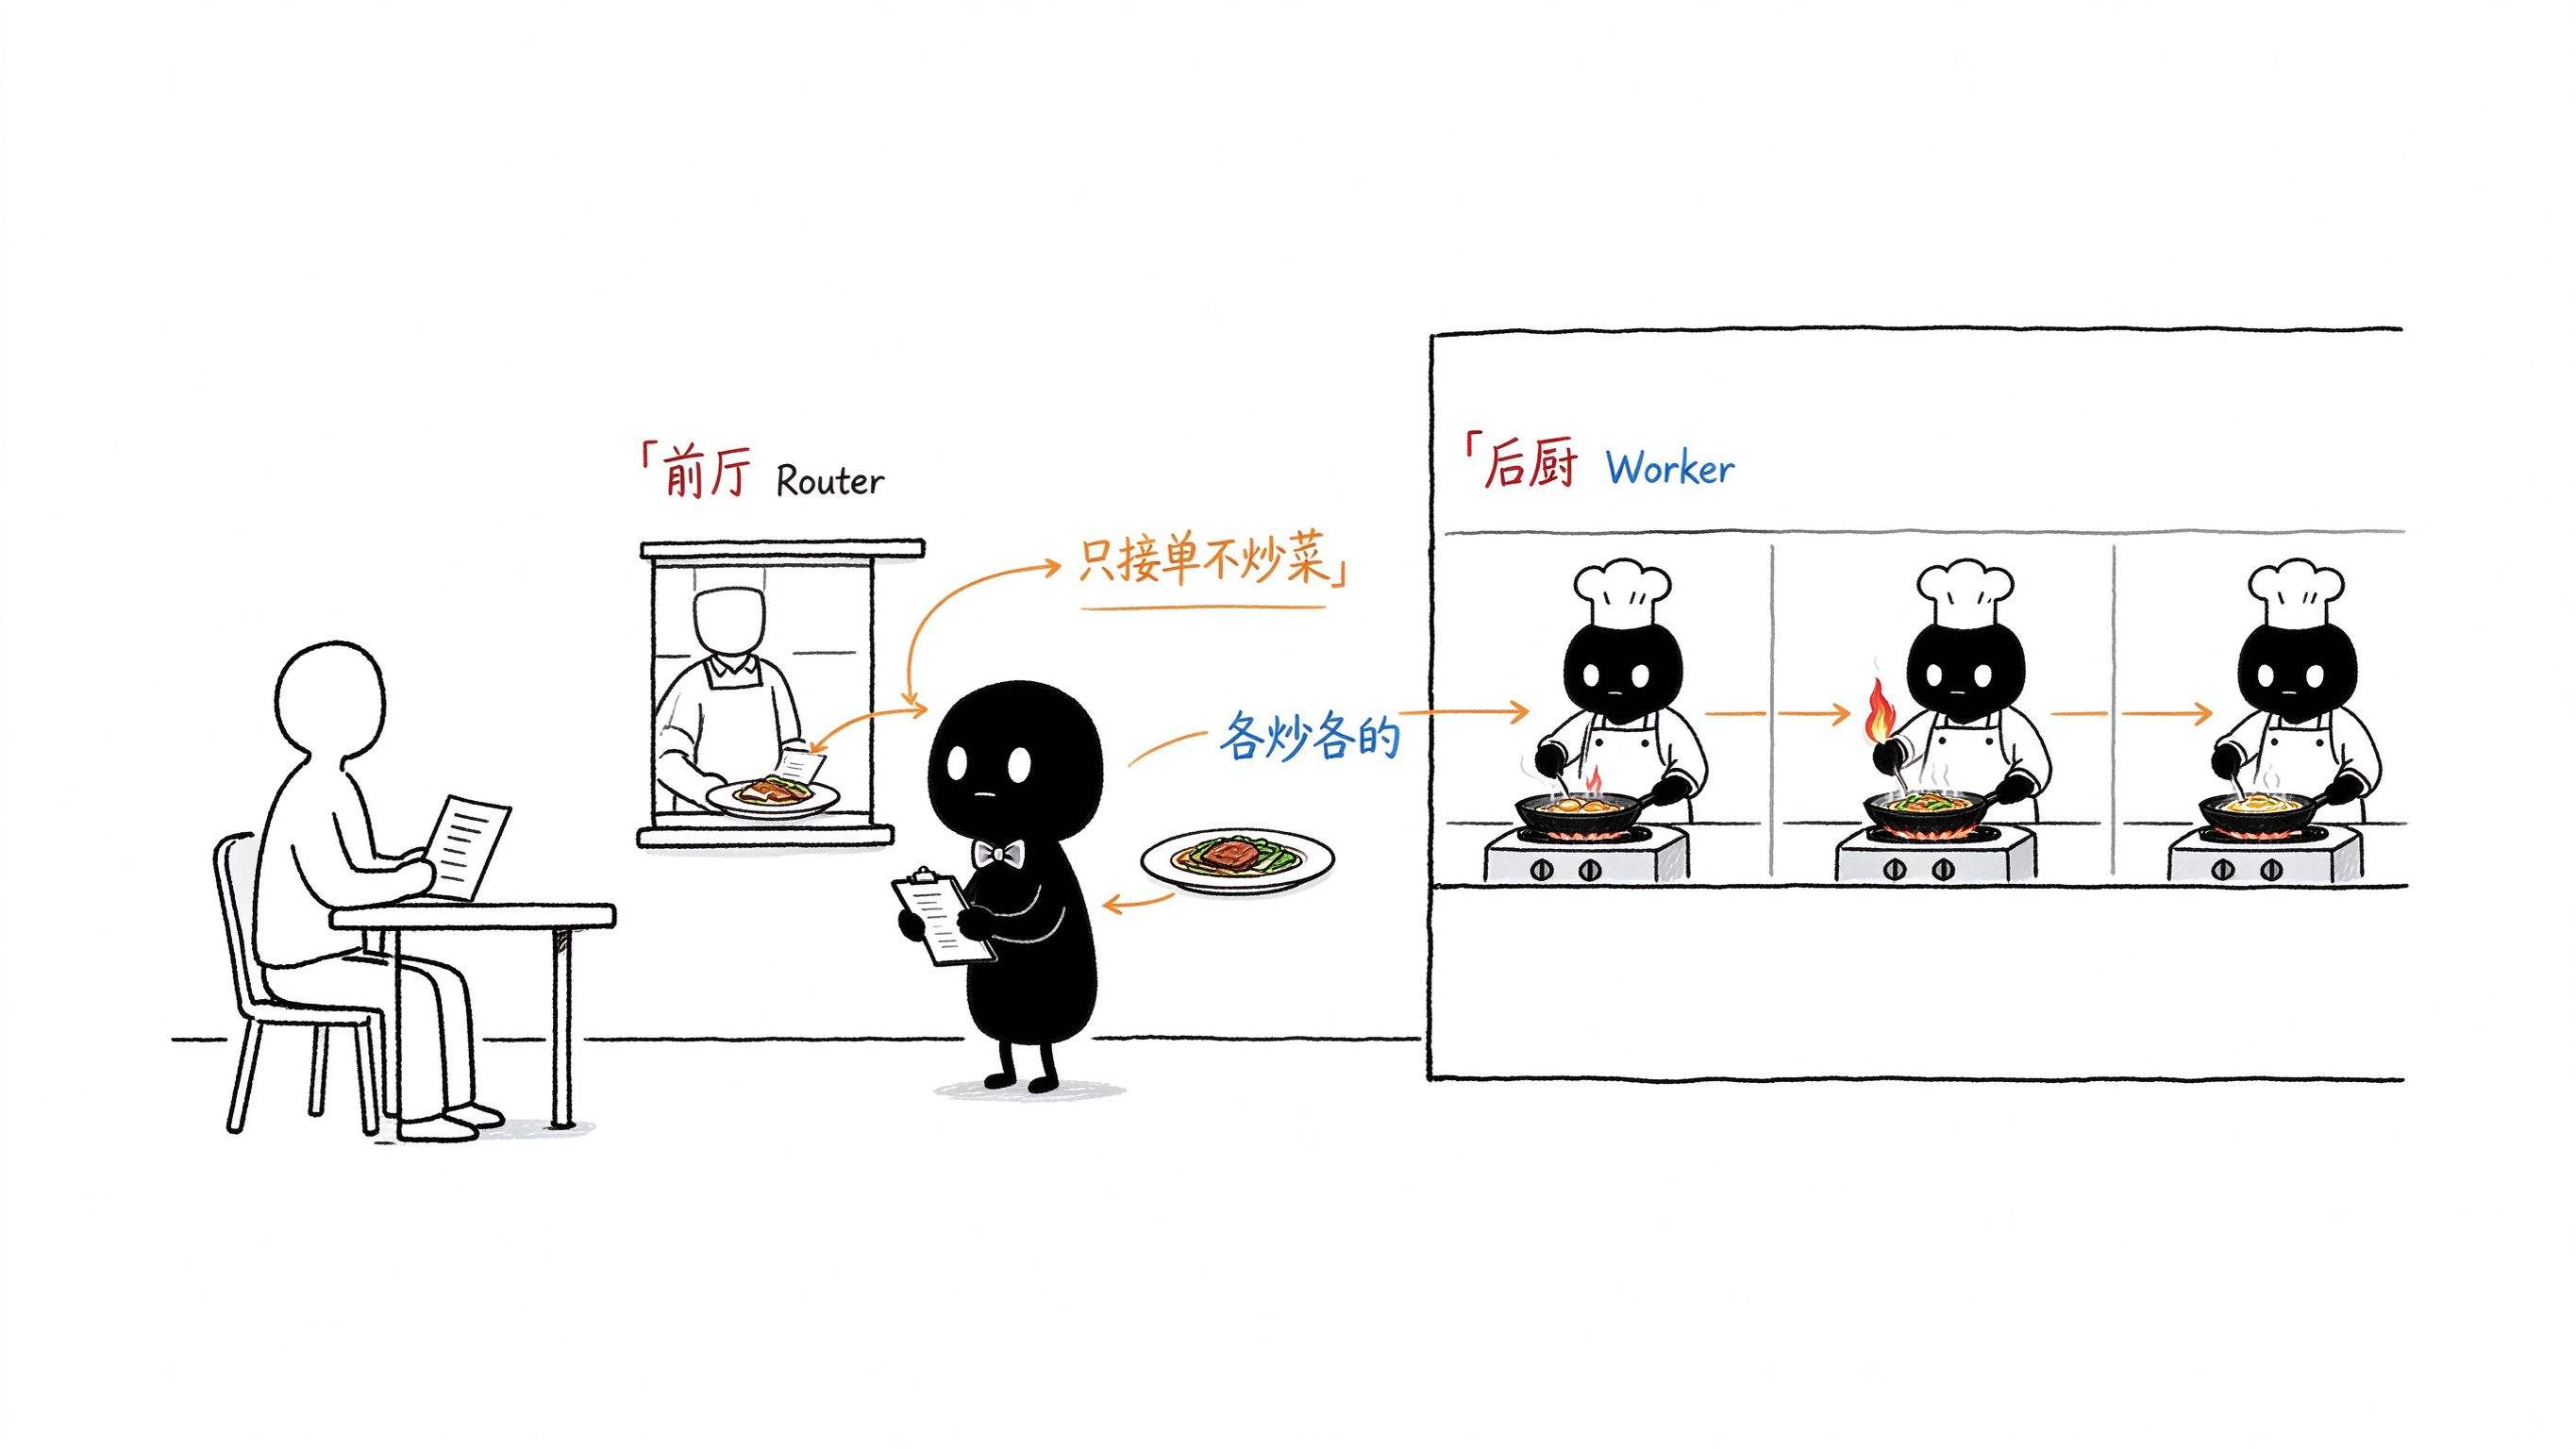
你去一家正常的馆子吃饭,跟你打交道的只有前厅服务员。点菜、加菜、催菜、退菜,都找他。他不炒菜,单子记下来往后厨一递就完事。后厨好几口锅同时开火,每个厨师只管自己手上那道菜,炒好了交给服务员端出来。你从头到尾不用知道后厨有几个人,也不用跑进去挨个问。
DeepSeek 的 Super-agent 分两层,跟这个几乎一模一样。上面一层叫 Router,负责跟人打交道,接收群聊、GitHub、邮件这些地方来的消息,记住全局的来龙去脉,然后把活分下去。下面一层叫 Worker,每个 Worker 开一个独立的会话,只干一件事,干完向 Router 汇报,由 Router 统一回复。
Router 被刻意设计成不干活,文章里说它甚至可以不配命令行工具。它的活是长输入、短输出,看一堆消息,回一句「这个交给谁」,所以用一个轻量的模型就够。Worker 要真写代码、真改 bug,结果好坏全看它,所以得配能力最强的模型。
服务员和大厨,本来就不用请同一个价钱的人。
文章里有个例子,我看了好几遍。
有个用户在群里说,希望正文、代码和终端的字体能分别设置。维护者 @ 了一下 Super-agent,让它支持一下。过了一阵,它在群里回,Pull Request 好了,设置里拆成三行字体,各自独立配置。用户接着问,字号也能分别配吗?它说可以,已经加进同一个 PR 了。
然后战场换到了 GitHub。维护者在 PR 下面评论,说设置项太多了,能不能折叠起来。它照改。设计师又说,这些本来就是字号设置,直接从「字号大小」那一行展开就行,不用单开一个分区。它又照改。最后它回到群里说了一句,PR 已合并。
一件事从群聊跑到 GitHub,又从 GitHub 回到群聊,中间换了三个人提意见,它一直知道这是同一件事。对提需求的人来说,他只是在跟一个同事说话,后面开了几个会话,他根本看不见。
这里面有个设计很巧,DeepSeek 叫它订阅和直通。还是拿餐馆说,一桌客人点了菜以后又要加辣,服务员没必要再去前厅重新登记一遍,直接冲后厨喊那口锅就行。Super-agent 里,一个 Worker 接下某个 PR 以后,就直接订阅这个 PR 后面的所有评论,新意见不经过 Router,直接送到它手上。
他们做实验专门把这个机制关掉对比过。关掉以后,Router 要做的决定多了大约 30%,读缓存的 token 从 2323 万涨到了 3177 万。
另一个例子更有意思。
一个产品用户群,每天消息很多,没人 @ 它,它就在旁边安静地看着。有个用户在群里抱怨,说在 macOS 桌面端,窗口没聚焦的时候点一下会话,会被识别成双击,然后进入重命名,他每天要误触几十次。
还是没人 @ 它。它自己判断这是一个具体的 bug,在后台复现、查代码,最后在群里发了一个修复的 PR,附上前后对比截图,顺手说明了原因,Electron 默认会吞掉激活窗口的那次点击,下一次点击就带上了 detail=2,所以被当成了双击。
最好的同事,是你没开口,他已经把事办完了。
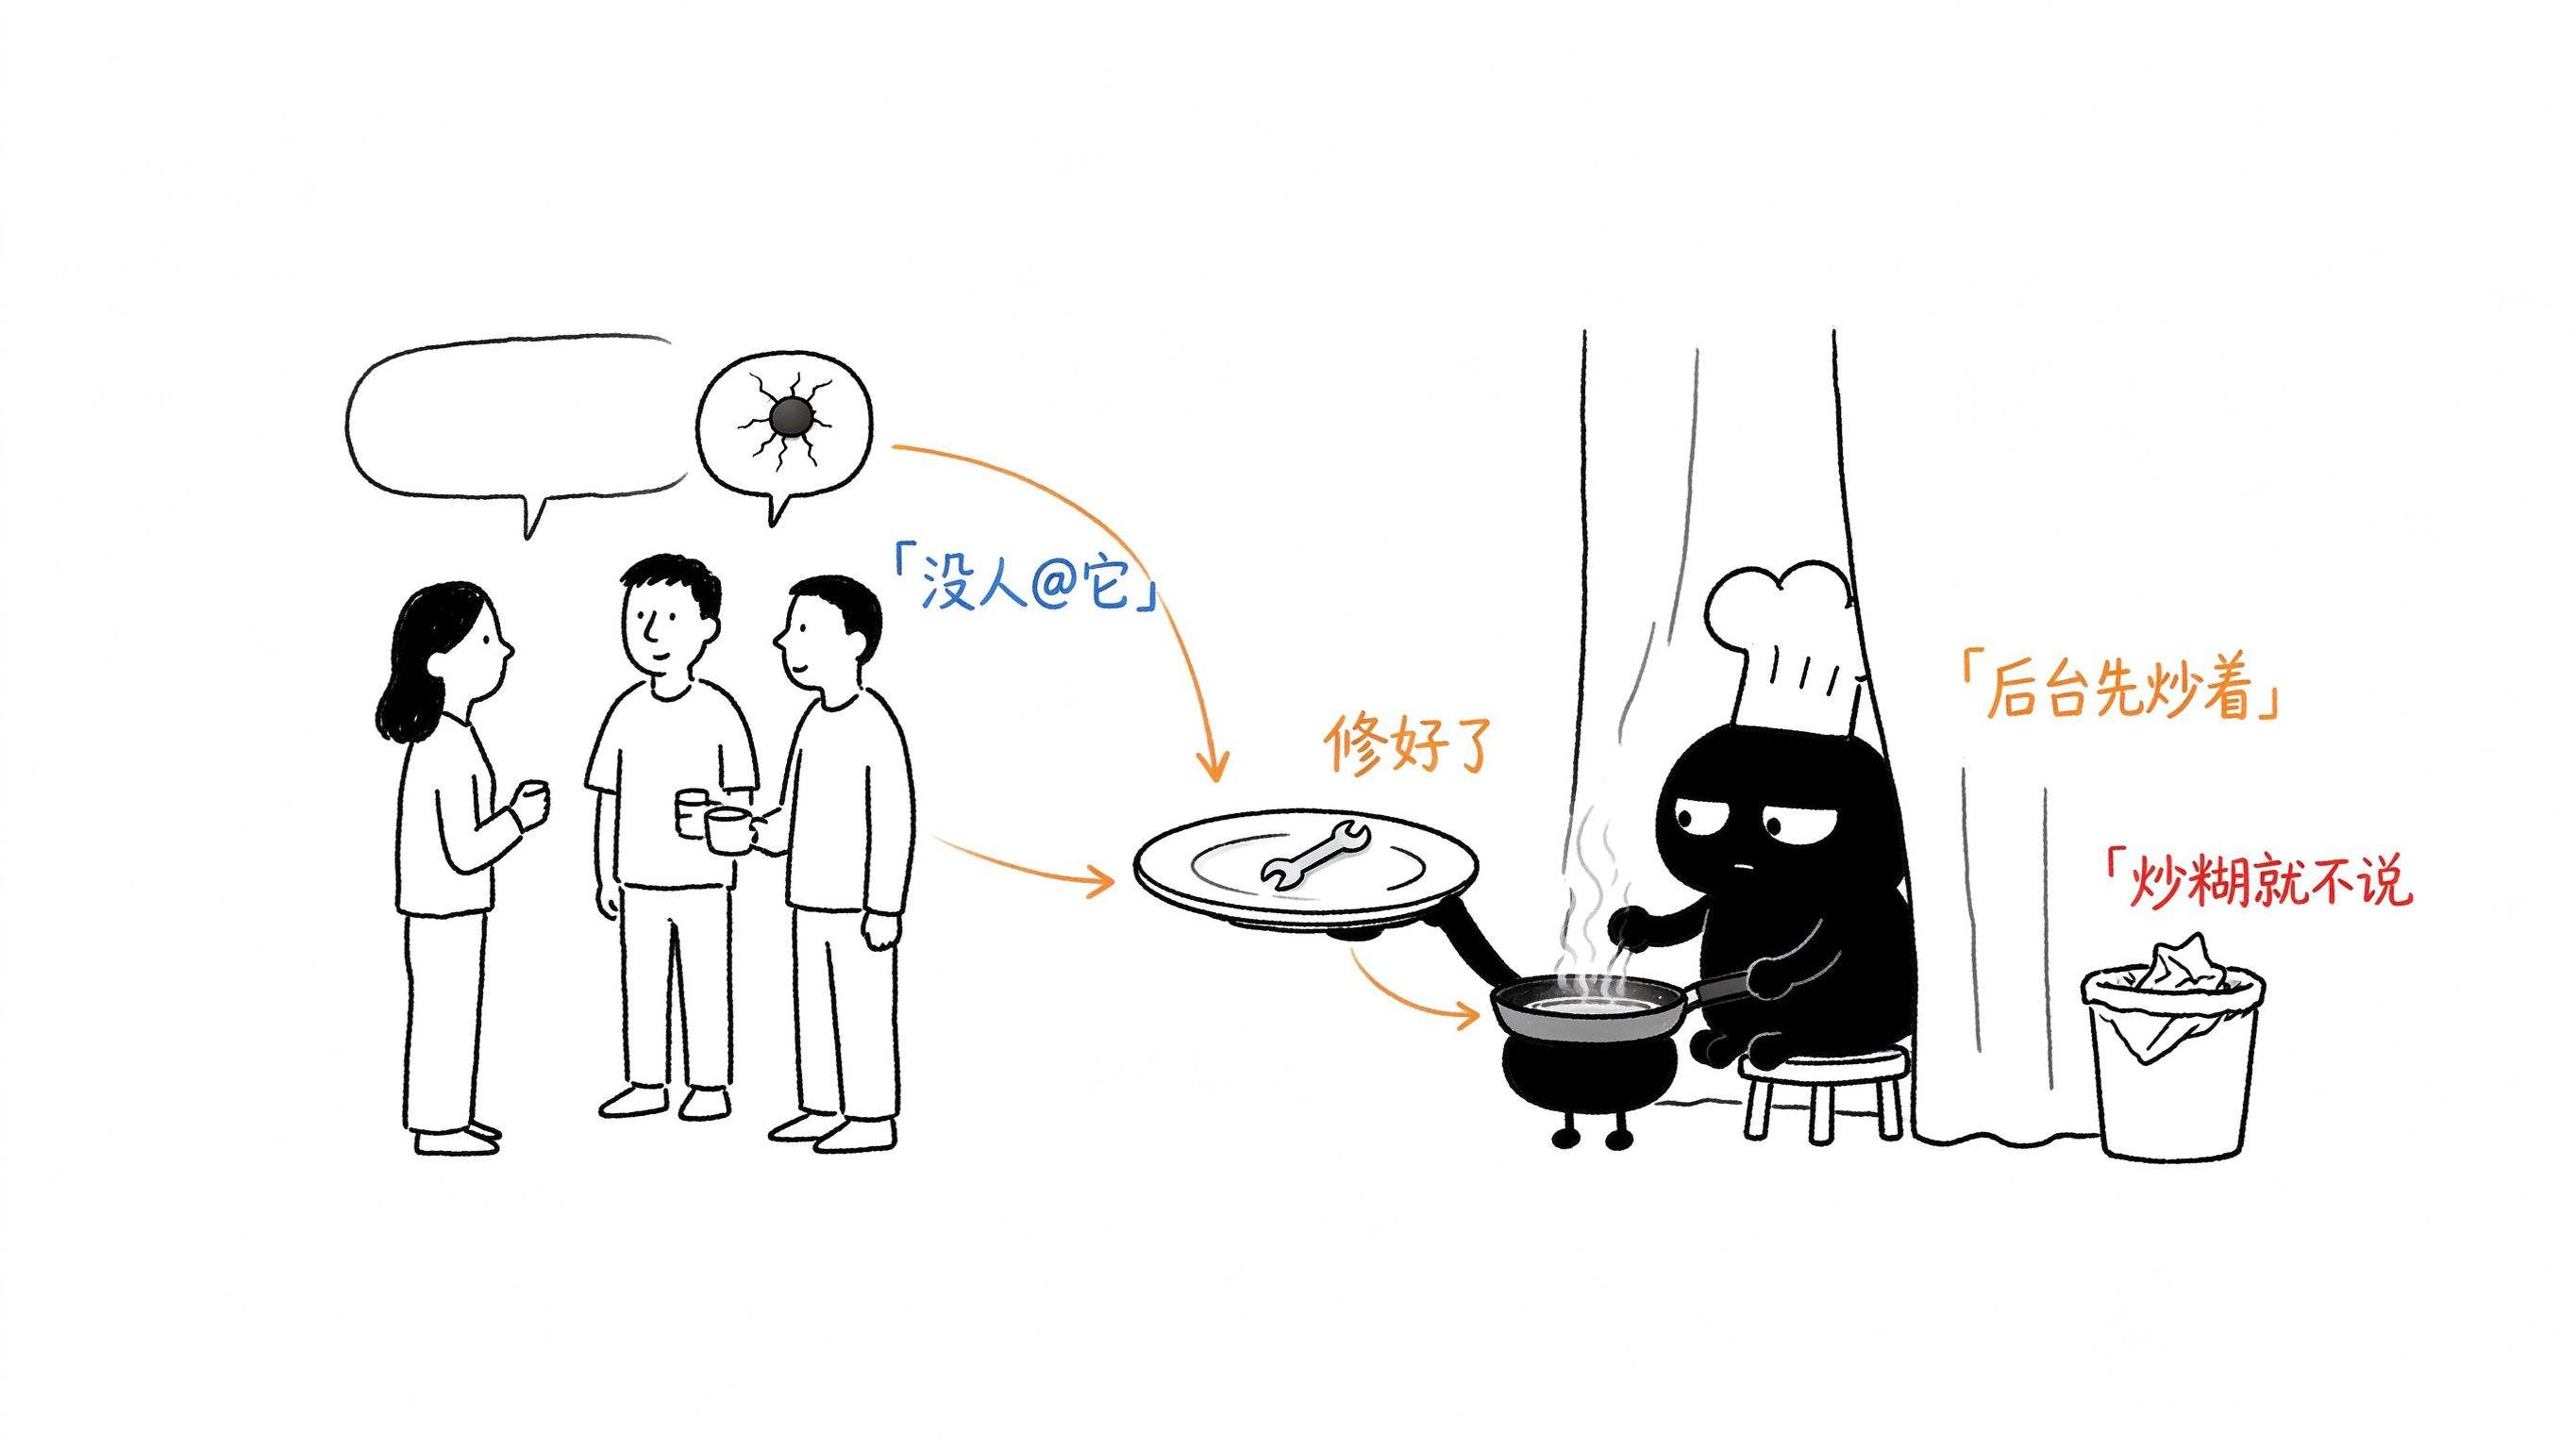
DeepSeek 管这个叫投机执行,这个词是从 CPU 设计里借过来的。CPU 遇到一个还没算出结果的分支,会先猜一个方向往下跑,猜对了白赚时间,猜错了把结果扔掉就是。Super-agent 也是这么干的,看到群里在讨论一个问题,先在后台试着复现和修,修出来了再说话,修不出来就当什么都没发生。
这句「修不出来就不说话」,我觉得是整篇文章最值钱的地方。
DeepSeek 在开源仓库的说明里写了一条原则,大意是尽量少占用人的注意力,尽量多给出价值。后面还跟了一句挺清醒的话,一个能替整个团队干活的 Agent,也能浪费整个团队的注意力。所以它只在有人要它干、或者团队写好的规则允许时才动手,只在有人必须处理、或者结果能派上用场时才开口。
一个会主动干活的 AI,要是每发现一点小事就在群里冒个泡,那它比一个不干活的 AI 还烦人。
主动不难,难的是知道什么时候闭嘴。
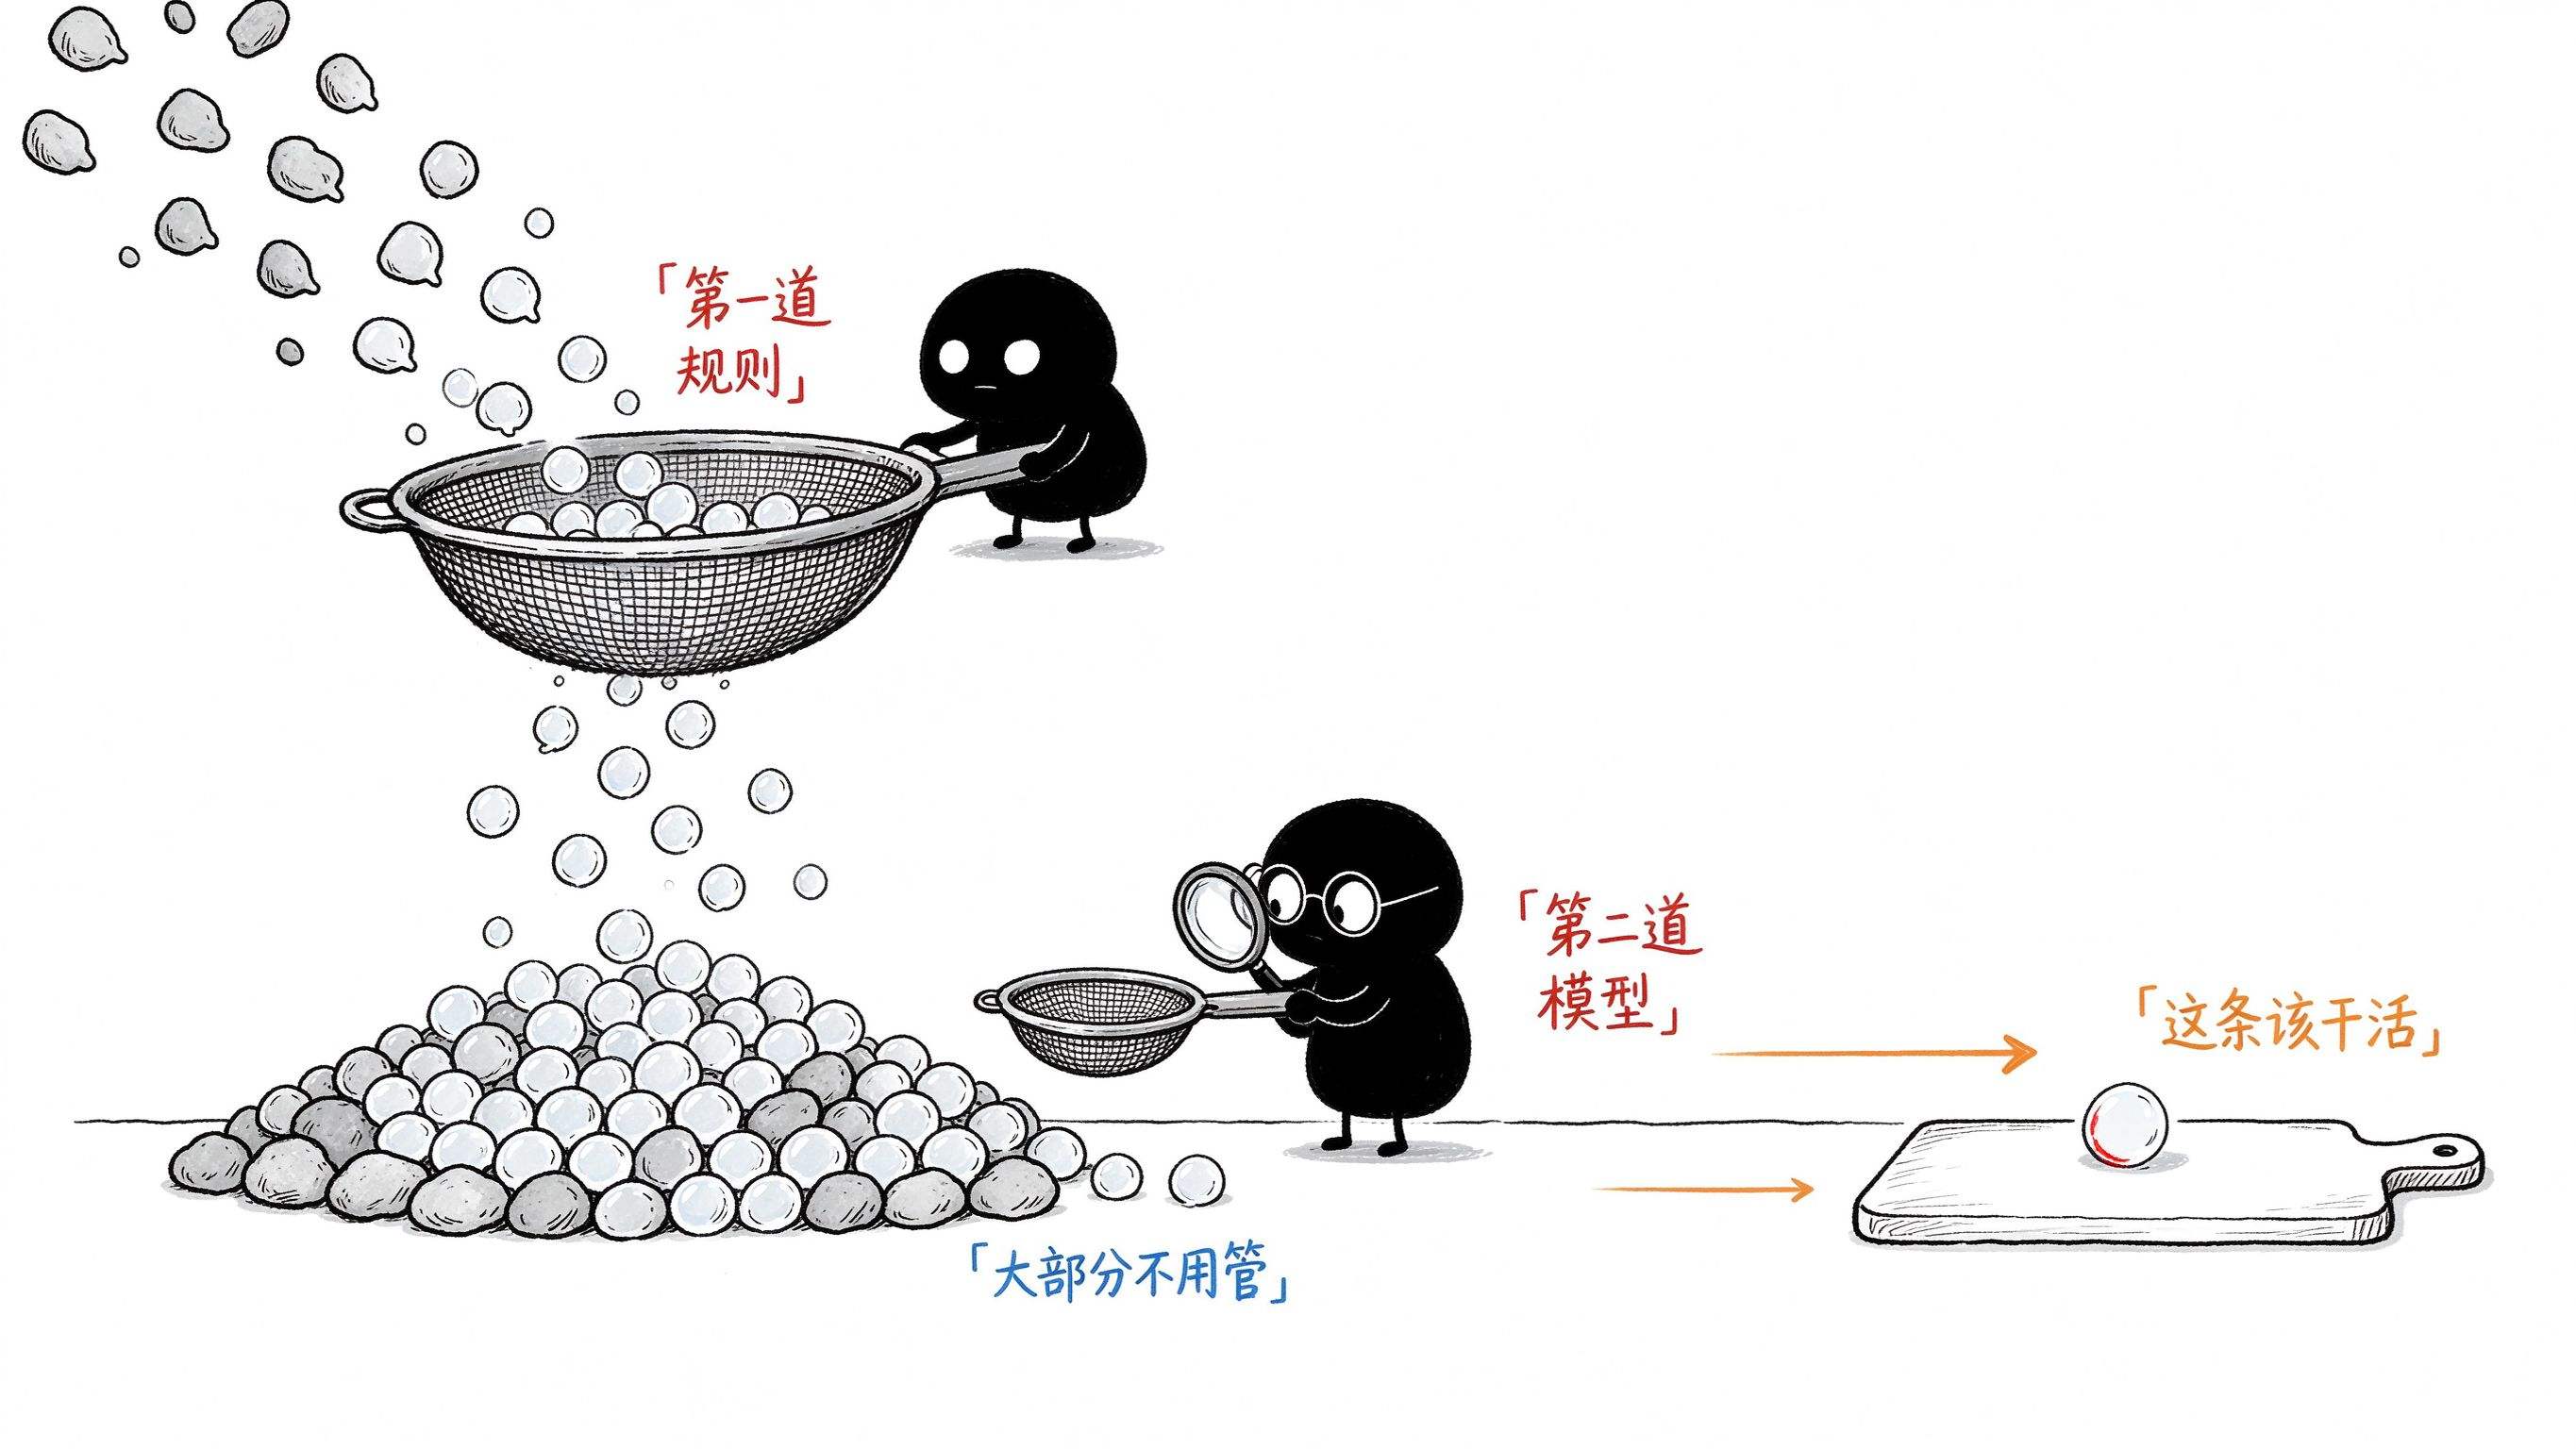
为了让它在一大堆闲聊里分清什么该管,DeepSeek 做了两道筛子。第一道是写死的程序规则,看消息从哪个群来、是谁发的,大部分无关消息在这一步就扔掉了,不用调大模型。剩下的才交给大模型判断要不要管。文章里画的例子挺生活,有人在闲聊群问中午去食堂还是点外卖,第一道筛子就筛掉了;有人在用户群里说新版界面挺清爽,大模型看了一眼,没什么要做的,不吭声;有人说切换会话时偶发白屏,这条才被放进来干活。
说到这儿,我得说一下我一开始的担心。
前阵子 Anthropic 在一份写给企业的智能体指南里吐槽过,很多公司给每个团队、每类问题各配一个子智能体,最后智能体架构成了公司组织架构图的复印件。他们的建议是,能并回主循环的子智能体就并回去。
DeepSeek 这套分了 Router 和 Worker 两层,乍一看也挺像一张组织架构图,前台加一群执行的人。
我仔细读了一遍,觉得两件事其实不冲突。Anthropic 吐槽的是按部门切,订单一个智能体,物流一个智能体,会员一个智能体,每个都常驻、各管一摊。DeepSeek 是按事情切,一件事开一个 Worker,事情办完 Worker 就可以退场,下一件事再开新的。Router 也不去插手单个任务怎么拆,文章专门强调了这点,它跟常见的 Agent Team 里那种事事过问的组长不一样。
餐馆后厨也是这个道理。没有哪家馆子会给宫保鸡丁配一个专职厨师,给鱼香肉丝再配一个,来一桌客人,哪个灶空着就谁炒。
当然,这套东西离真正能用还有距离,DeepSeek 自己也说得很清楚。
实验数据是有的。每轮大约 300 条消息,里面混着 20 条左右真正要干的活,每种方案跑 5 次。Super-agent 一半的任务 12.4 分钟内完成,95% 的任务 15.7 分钟内完成;对照的单会话加 Subagent 方案,在中性提示下 95% 的任务要 29.5 分钟。消息涌进来越多,Router 越会把积压的消息合并成一批处理,单个决定分摊下来的推理时间从 6.4 秒降到了 1.6 秒。
但文章自己就说了,这些实验用的是合成负载和简化环境,消息间隔和工作时长还按四分之一缩放过,测的是调度和协作,不是单个任务做得好不好。前面那个异步机制,让它在跑长任务时还能接着听你说话的那个,已经在 DeepSeek Harness 里实现了,但还没默认开启。
开源出来的 dsh-superagent-prototype,README 第一行就写着,研究原型,仅供参考,不是 DeepSeek 的正式产品。它还说这份代码大部分工程是 coding agent 写的,风格可能不统一,可能有 bug。我看到这句笑了一下,一个让 AI 自己找活干的项目,本身就是 AI 干出来的。
还没解决的问题,文章也列了一串。Router 规模再大怎么扩,跨月甚至更久的长期记忆怎么做,还有安全。一个云端 Agent 接到你本地的开发机上,提示词注入、本地凭据泄露、跨设备的权限,每一样都不是小事。它在群里安静地看着所有消息,要是有人故意往群里塞一句精心设计的话呢?这个我还没想好答案,DeepSeek 也没给。
最后回到开头那个数字,一个人最多盯 3 到 5 个窗口。
过去一年大家都在比谁家模型能独立干更久的活,跑一小时、跑一整天。DeepSeek 这篇文章换了个问题,模型能干的活越来越多,人怎么才能不被这些活淹掉。
它给的答案就是那家餐馆。你只跟一个服务员说话,后厨开多少口锅、谁炒哪道菜,你不用管。偶尔服务员端上来一道你没点的菜,说刚才听你提了一句,后厨顺手做了,你尝一口,发现确实是你想要的。
以后衡量一个 Agent 好不好,可能不看它能干多少活,要看它占了你多少注意力。
谢谢你看我的文章,我们,下次再见。
/ 作者:青玉白露
评论区
欢迎留下你的看法,支持匿名评论。
你的评论会公开展示,建议填写便于交流的昵称,并尽量提供有信息量的反馈。