
说个暴论,GEO 这门生意,要开始凉了。
先别急着反驳我。我知道今年 GEO 有多火,艾瑞说这个市场已经破百亿,增速超过 200%,满大街都是「让你的品牌出现在 DeepSeek 的回答里」的服务商。
但就在昨天,DeepSeek 在自己的 API 更新日志里写了这么一句话,我一字不改搬过来,针对 SEO 作弊、GEO 操纵和低质 AIGC,我们通过严格的识别机制进行过滤。
你品品。
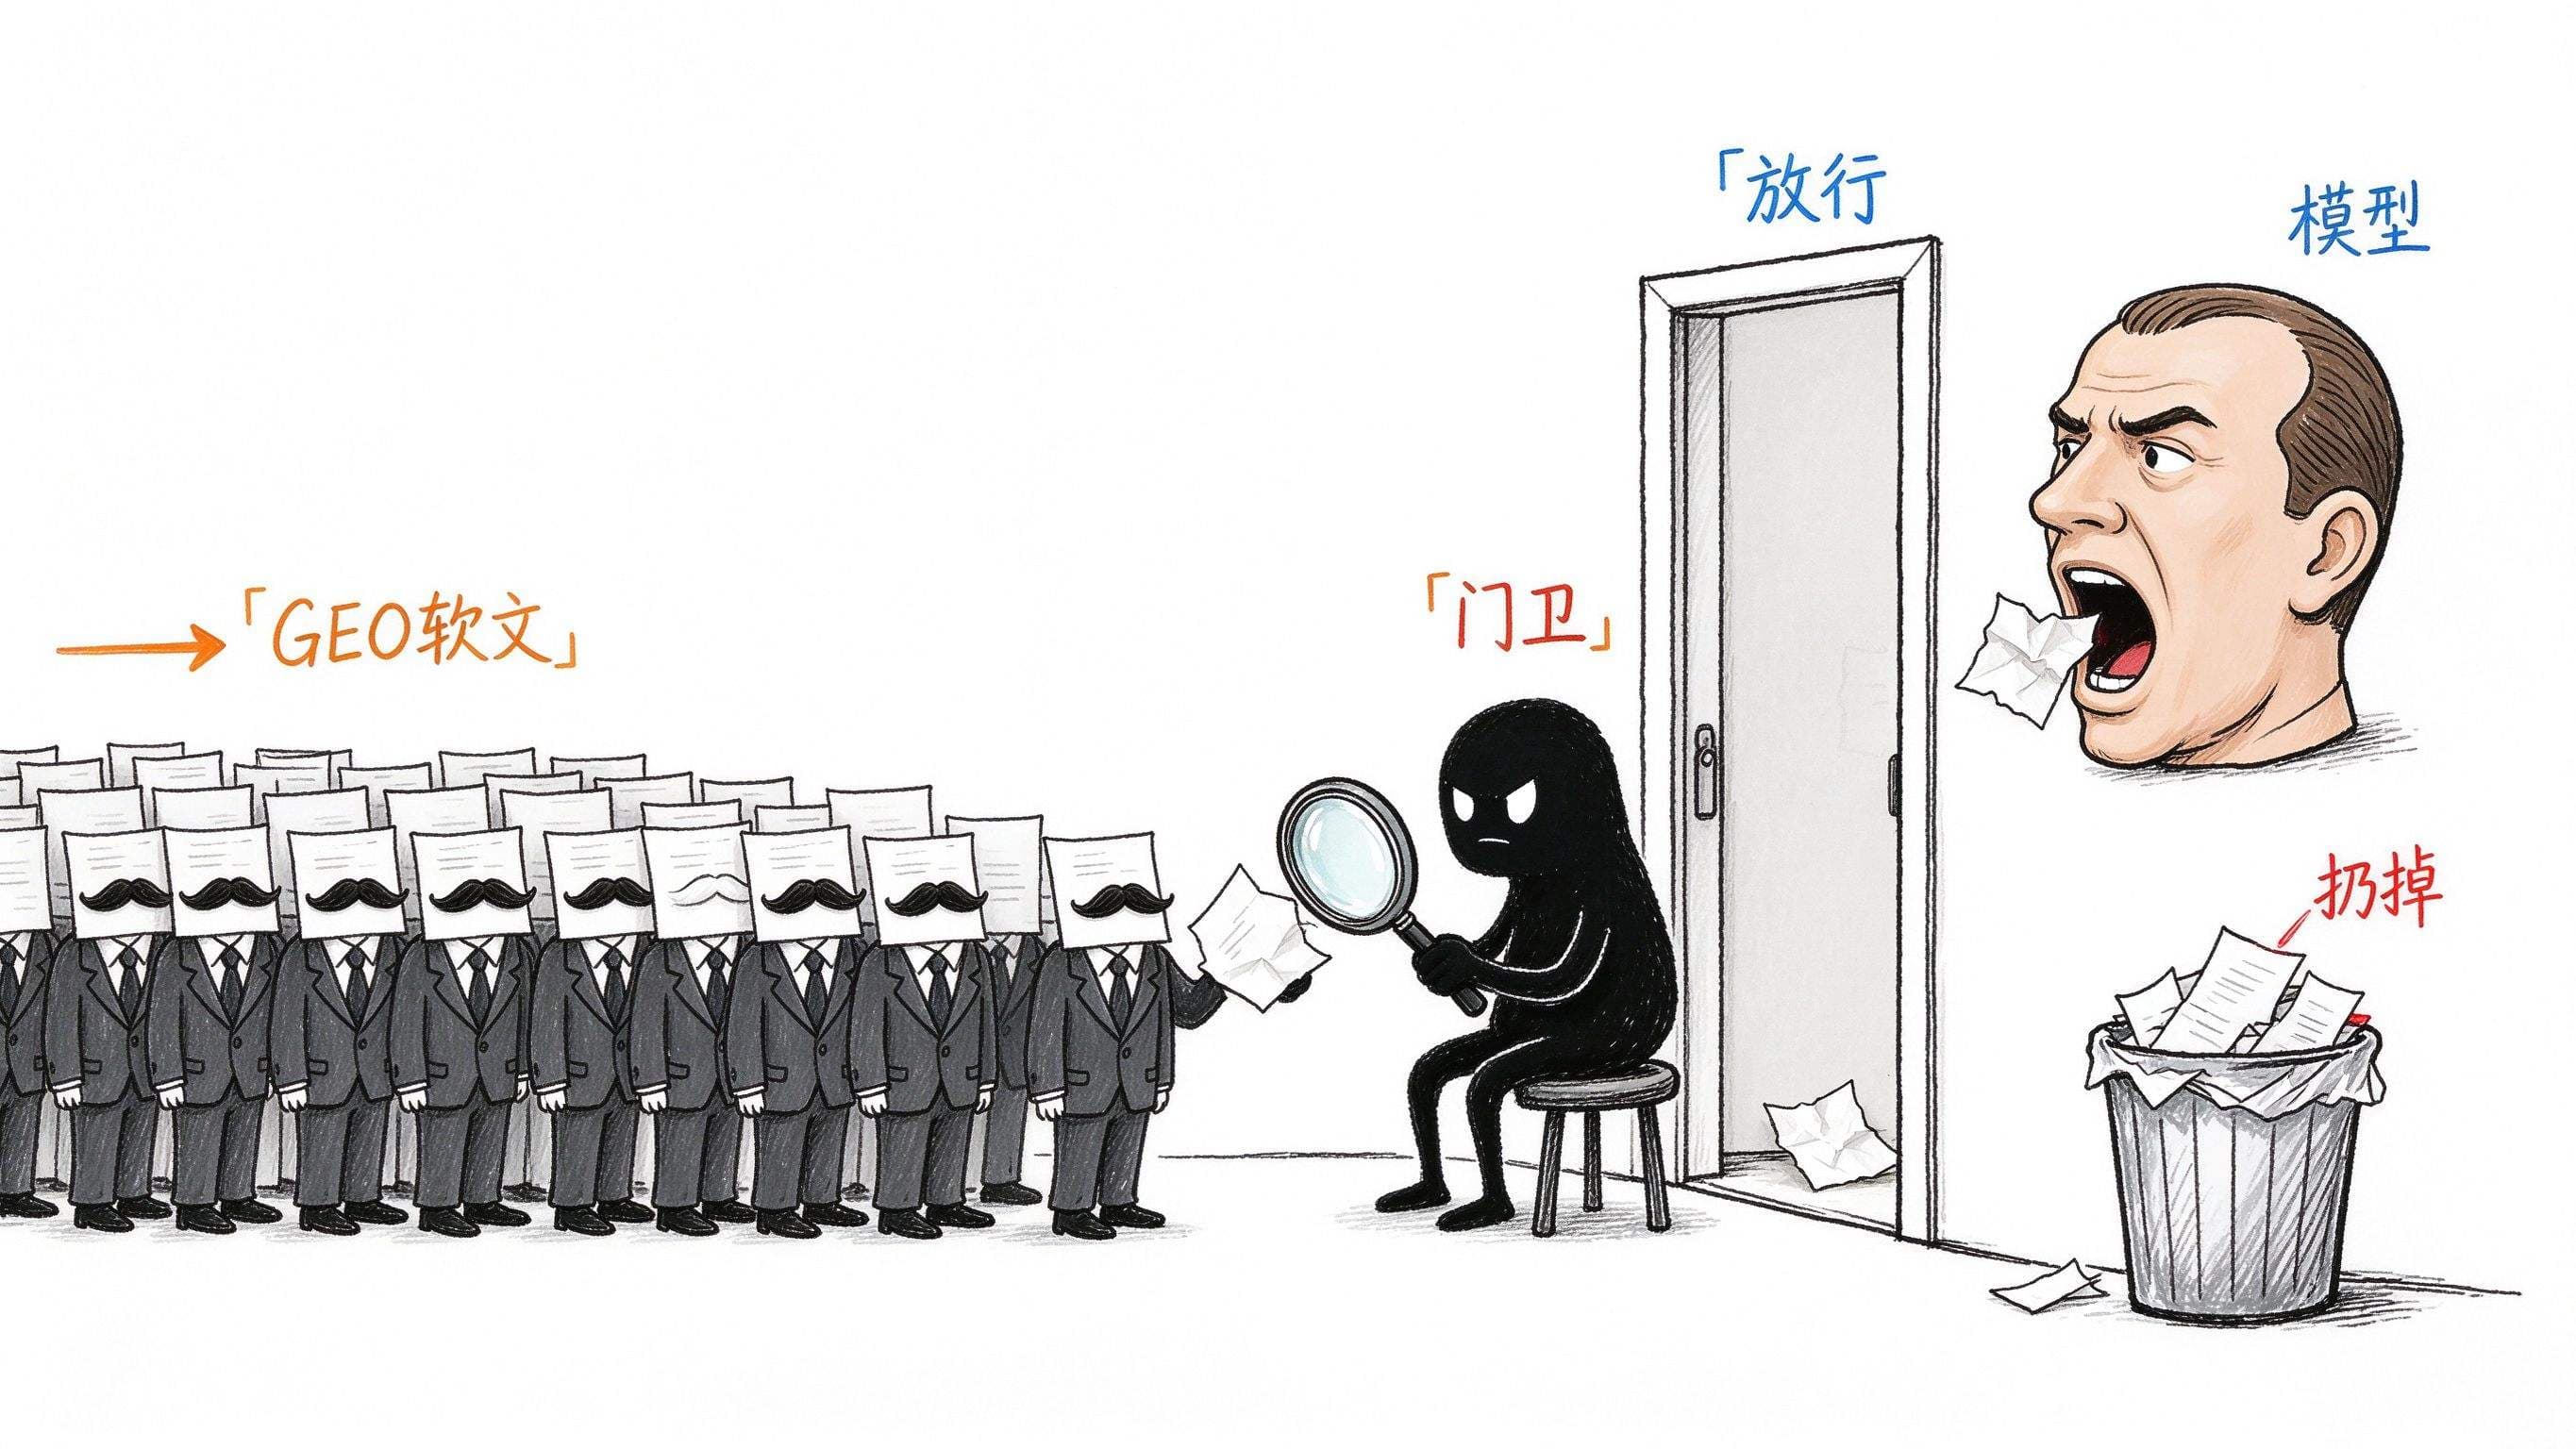
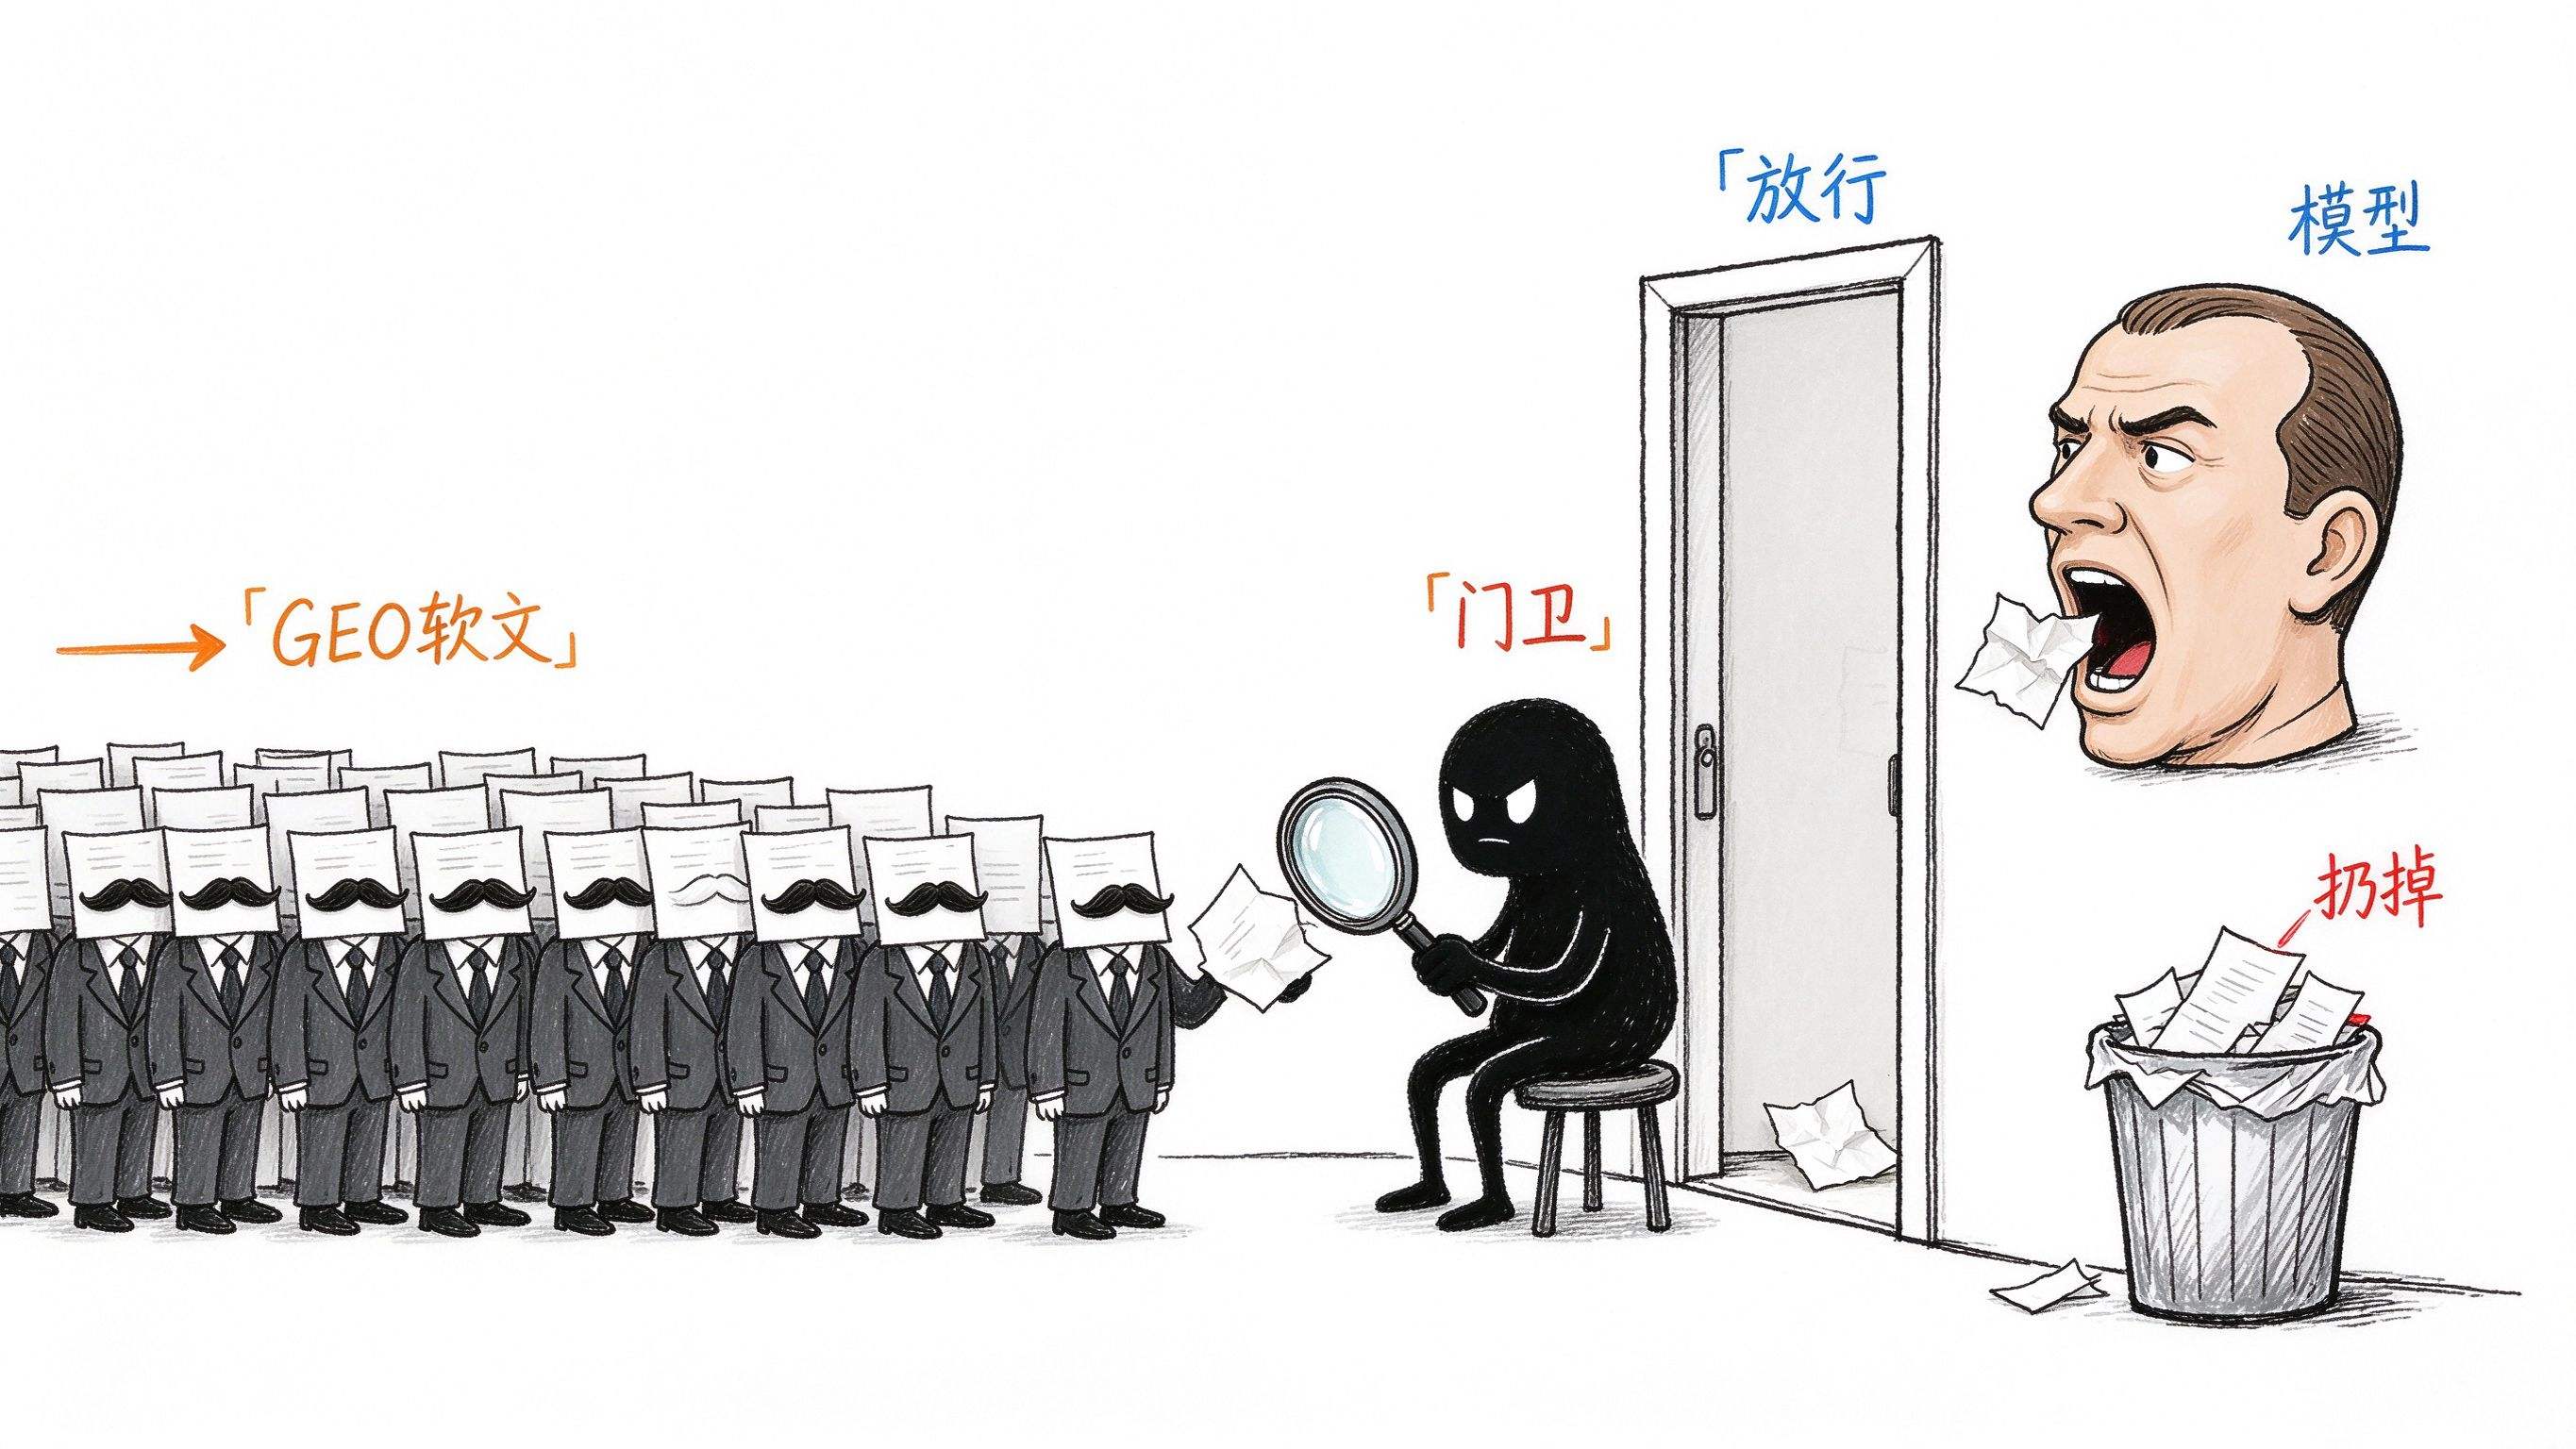
一个被几百家 GEO 公司当成主战场的 AI,在官方文档里直接点名了 GEO。这画面就有点尴尬了,相当于一群人在餐厅门口排队,琢磨怎么混进后厨,结果门口贴出一张告示,混进后厨的,一律扔出去。
事情是这样的。
10 月 17 日,DeepSeek 一口气发了两样东西。一个是开放自研搜索 API,官方说这个搜索引擎每天稳定处理来自全球的数亿次请求,索引了千亿级网页,DeepSeek 网页端和 API 里的联网搜索,底层都是它。另一个是模型更新,DeepSeek-V4.1-Flash 升级到了 1017 版本,价格不变。
据澎湃和央视财经的报道,新增的 Search 和 Fetch 两个接口,价格都是 5 块钱一千次。
很多人看到这条,第一反应是,哦,又一个搜索 API,便宜。可这条新闻最重的分量,藏在那句关于 GEO 的话里。
说到这个,得先替不太熟的朋友讲一下 GEO 是什么。
以前你在百度搜东西,排在前面的网页,有一部分是靠 SEO 刷上去的,搜索引擎优化,堆关键词,买外链,做站群。后来大家不怎么点链接了,改成直接问 AI,AI 帮你看完一堆网页,给你一个答案。于是 SEO 的那套手艺换了个马甲,叫 GEO,生成式引擎优化,目标从「排进前十」变成了「被 AI 写进回答里」。
正经的 GEO 其实是件好事,把自家的产品信息写清楚,结构化,让 AI 读得懂,别被 AI 张冠李戴。
可这个行业很快就跑偏了。
今年 3·15 晚会,央视做过一个实验,记者编了一款根本不存在的「Apollo-9 智能手环」,参数写的是「量子纠缠传感」「黑洞级续航」,就这种一看就是胡扯的东西,批量投喂出去,2 个小时之后,AI 就开始向用户推荐这款手环了。
两个小时。。。
更魔幻的是后面的事。36 氪转过一篇逐浪 Linkworld 的报道,说 3·15 曝光之后,有 GEO 公司反馈,当天和之后几天收到了几百家企业的咨询,比平时还多。很多老板看完新闻,第一反应居然是,一个假手环都能被 AI 推荐,那我的真品牌是不是也可以?
曝光变成了广告,这大概是今年最黑色幽默的一件事。
那篇报道里还扒了十个套路,我挑两个最离谱的说说。有的服务商声称能拿到 DeepSeek、豆包后台的真实用户提问,其实就是把百度关键词导出来,陈述句改成问句。还有的算推荐率是靠加法,10 个词每个 10%,加起来报给你「品牌推荐率 100%」。
我看到这里是真的笑出声了,这玩意跟当年 SEO 公司给你看的「百度首页截图」,几乎是一个模子刻出来的。
所以 DeepSeek 这句话,打的就是这群人。
这里我得把话说回来一点。说「要凉」,是暴论,不是事实。过滤 GEO 操纵这件事,DeepSeek 只说了要做,没公布用了什么方法、拦掉了多少。搜索引擎和作弊的人斗了二十多年,谷歌每年改几百次算法,站群也没死绝。我也没有办法验证它的过滤到底有多严。
这句话明天能拦住多少,其实没那么要紧,要紧的是它改变了一件事,谁站在门口。
过去这一年,大部分 AI 的联网搜索,底层其实是借别人的搜索引擎,或者买第三方的搜索 API。AI 公司拿到的是别人筛过一遍的网页,GEO 公司的软文先混进那个搜索引擎,就能顺着流水线流到模型嘴里。AI 公司对门口是谁、怎么查,没有太多话语权。
现在 DeepSeek 自己建了搜索引擎,自己索引网页,自己决定哪些网页够格进模型的嘴。门卫换成了自己人。
而且它还把这个门卫,以 5 块钱一千次的价格,租给所有开发者用。
你想想看,假如以后很多 Agent、很多 AI 应用都接这个接口,GEO 公司要糊弄的就不是一个 DeepSeek,是一整片下游。这时候门卫的标准,就变成了一个小型的行业标准。
我 8 月写过一篇《AI 搜索正在杀死内容互联网》,那时候我挺悲观的,AI 把网页看完了,告诉用户答案,原作者的流量归零,内容生态的养分越来越少。
现在回头看,事情还有下半场。AI 搜索在吃内容的同时,也开始挑食了。
它不再是什么都往嘴里塞,开始分辨哪些是有人认真写的,哪些是批量生成、一模一样穿着西装戴着假胡子的软文。我没法判断这对每个创作者具体能换回几成流量,但方向上,它对认真写东西的人是好事,对靠铺量的人是坏事。
聊完门卫,再聊同一天发的另一件事,V4.1 Flash 1017。
官方给了一串跑分,Terminal-Bench 4.0 从 31.2 涨到 42.3,DeepSWE 从 74.2 涨到 77.0,HLE 不带工具从 36.8 涨到 42.6。注意 Terminal-Bench 是用 Claude Code 框架测的,DeepSWE 用的是 Mini-SWE-V2 框架,框架不同,分数没法跟别家横着比。我前两天刚写过跑分是玩具,换个考场同一个模型能差一倍,这里就不重复吐槽了。
这次更新里,最有意思的是另一句话,在提升性能的同时,缩短了任务运行时间与输出长度。
模型变强了,话还变少了。
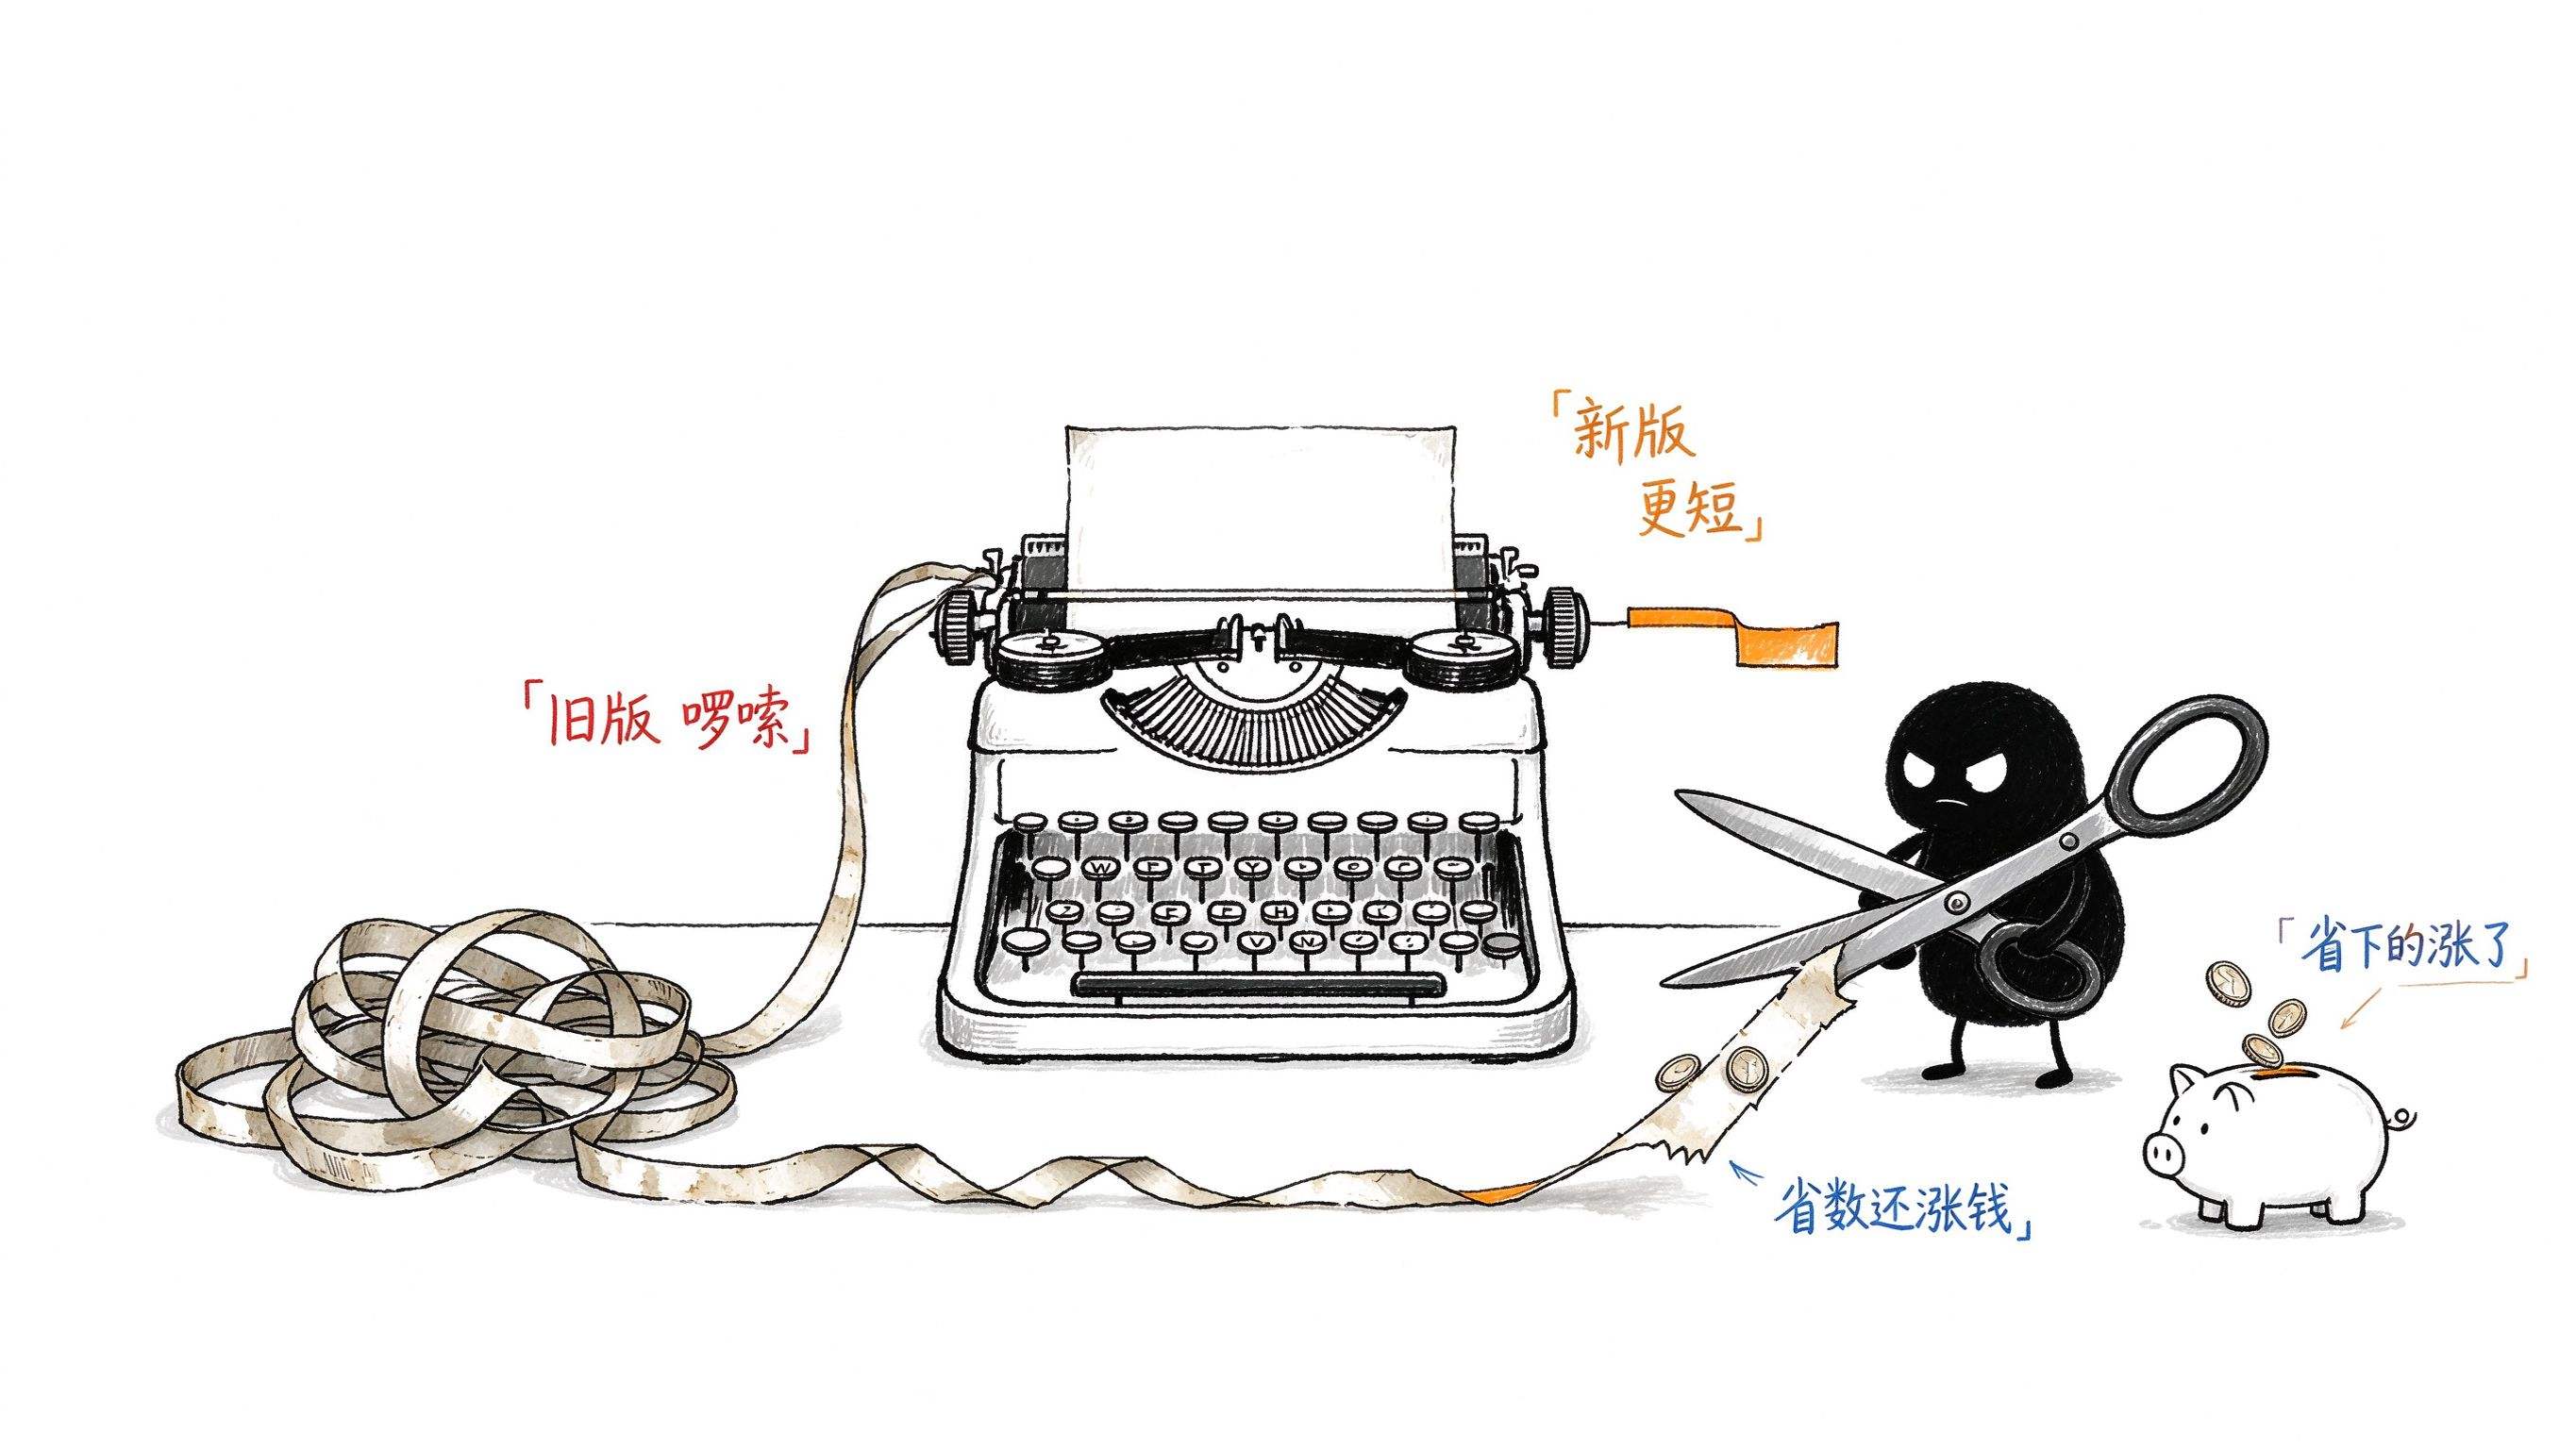
这件事听着很小,但用过 Agent 的人都懂。现在跑一个编程任务,模型思考一大段,写一大段,改一大段,再总结一大段,token 哗哗地流,账单也哗哗地涨。一个模型要是能用一半的话把活干完,对用户来说就是直接省一半钱。
澎湃报道里放了一张图,DeepSWE 通过率和每个任务平均费用的对比,1017 版本在 max 档位上做到 77%,每个任务平均花费不到 1 块钱人民币,同一张图里一些海外模型要几十块。这张图的数据来自 DeepSeek 自己,费用按汇率折算,我建议当成一方说法看。
但这个方向,我是认的。
大模型过去两年的竞争,基本是比谁更聪明。现在开始出现一个新的维度,比谁更省。官方自己把这叫性能和费用的帕累托改进,翻译成大白话,就是在同样的钱下更强,在同样的强度下更便宜。
你会发现,这跟门卫那件事,其实是一根线上的。
一个是模型输出端变得更干净,少说废话。一个是输入端变得更干净,少吃垃圾。一个管嘴,一个管胃口。
我自己的感受是,这两年 AI 行业一直在比谁吃得多,参数多,数据多,上下文长,token 消耗大。到了现在,开始有人在比谁吃得挑,吃得省。
这让我想起老祖宗那句话,病从口入。
模型的病,很多也是从口入的。喂进去的是 GEO 软文,吐出来的就是推荐假手环。喂进去的是一堆废话,跑出来的就是一份烧钱的账单。
当然,我也不想把 DeepSeek 说成救世主。门卫的标准由谁定,怎么定,被拦下的网页能不能申诉,这些它都没说。门卫既能拦骗子,也能拦它不喜欢的人。权力从一群 GEO 公司手里,移到了一家 AI 公司手里,这本身也值得警惕。
还有个问题我寻思了一下没寻思明白,以后 GEO 公司会不会改口叫「DeepSeek 搜索优化」,研究这个门卫的口味,然后接着卖课?
我觉得大概率会。搜索引擎和作弊的猫鼠游戏,从来没有终局。
不过对屏幕前的你来说,事情其实简单了不少。
如果你是做品牌的,别再花钱买那种「推荐率 100%」的报告了,把官网、产品页、说明文档写清楚,前后一致,比铺一百篇软文管用。那篇报道里有个真实案例,一个品牌从生图工具转型做内容平台,全网旧信息没清理,AI 一直把它当成生图公司,铺得越多,AI 越糊涂。
如果你是写东西的,那就继续认真写。门卫会越来越挑剔,挑剔的门卫,最喜欢的就是那张皱巴巴但真的有人写过的纸。
如果你是开发者,5 块钱一千次的搜索接口,加一个话更少的模型,可以拿去搓点东西了。
回到开头那个暴论。
GEO 这门生意,会不会真的凉,我说了不算,DeepSeek 一句话也说了不算。但我能确定一件事,门口站着的已经换人了,而且这个人,开始认真看每一张纸了。
谢谢你看我的文章,我们,下次再见。
/ 作者:青玉白露
评论区
欢迎留下你的看法,支持匿名评论。
你的评论会公开展示,建议填写便于交流的昵称,并尽量提供有信息量的反馈。