
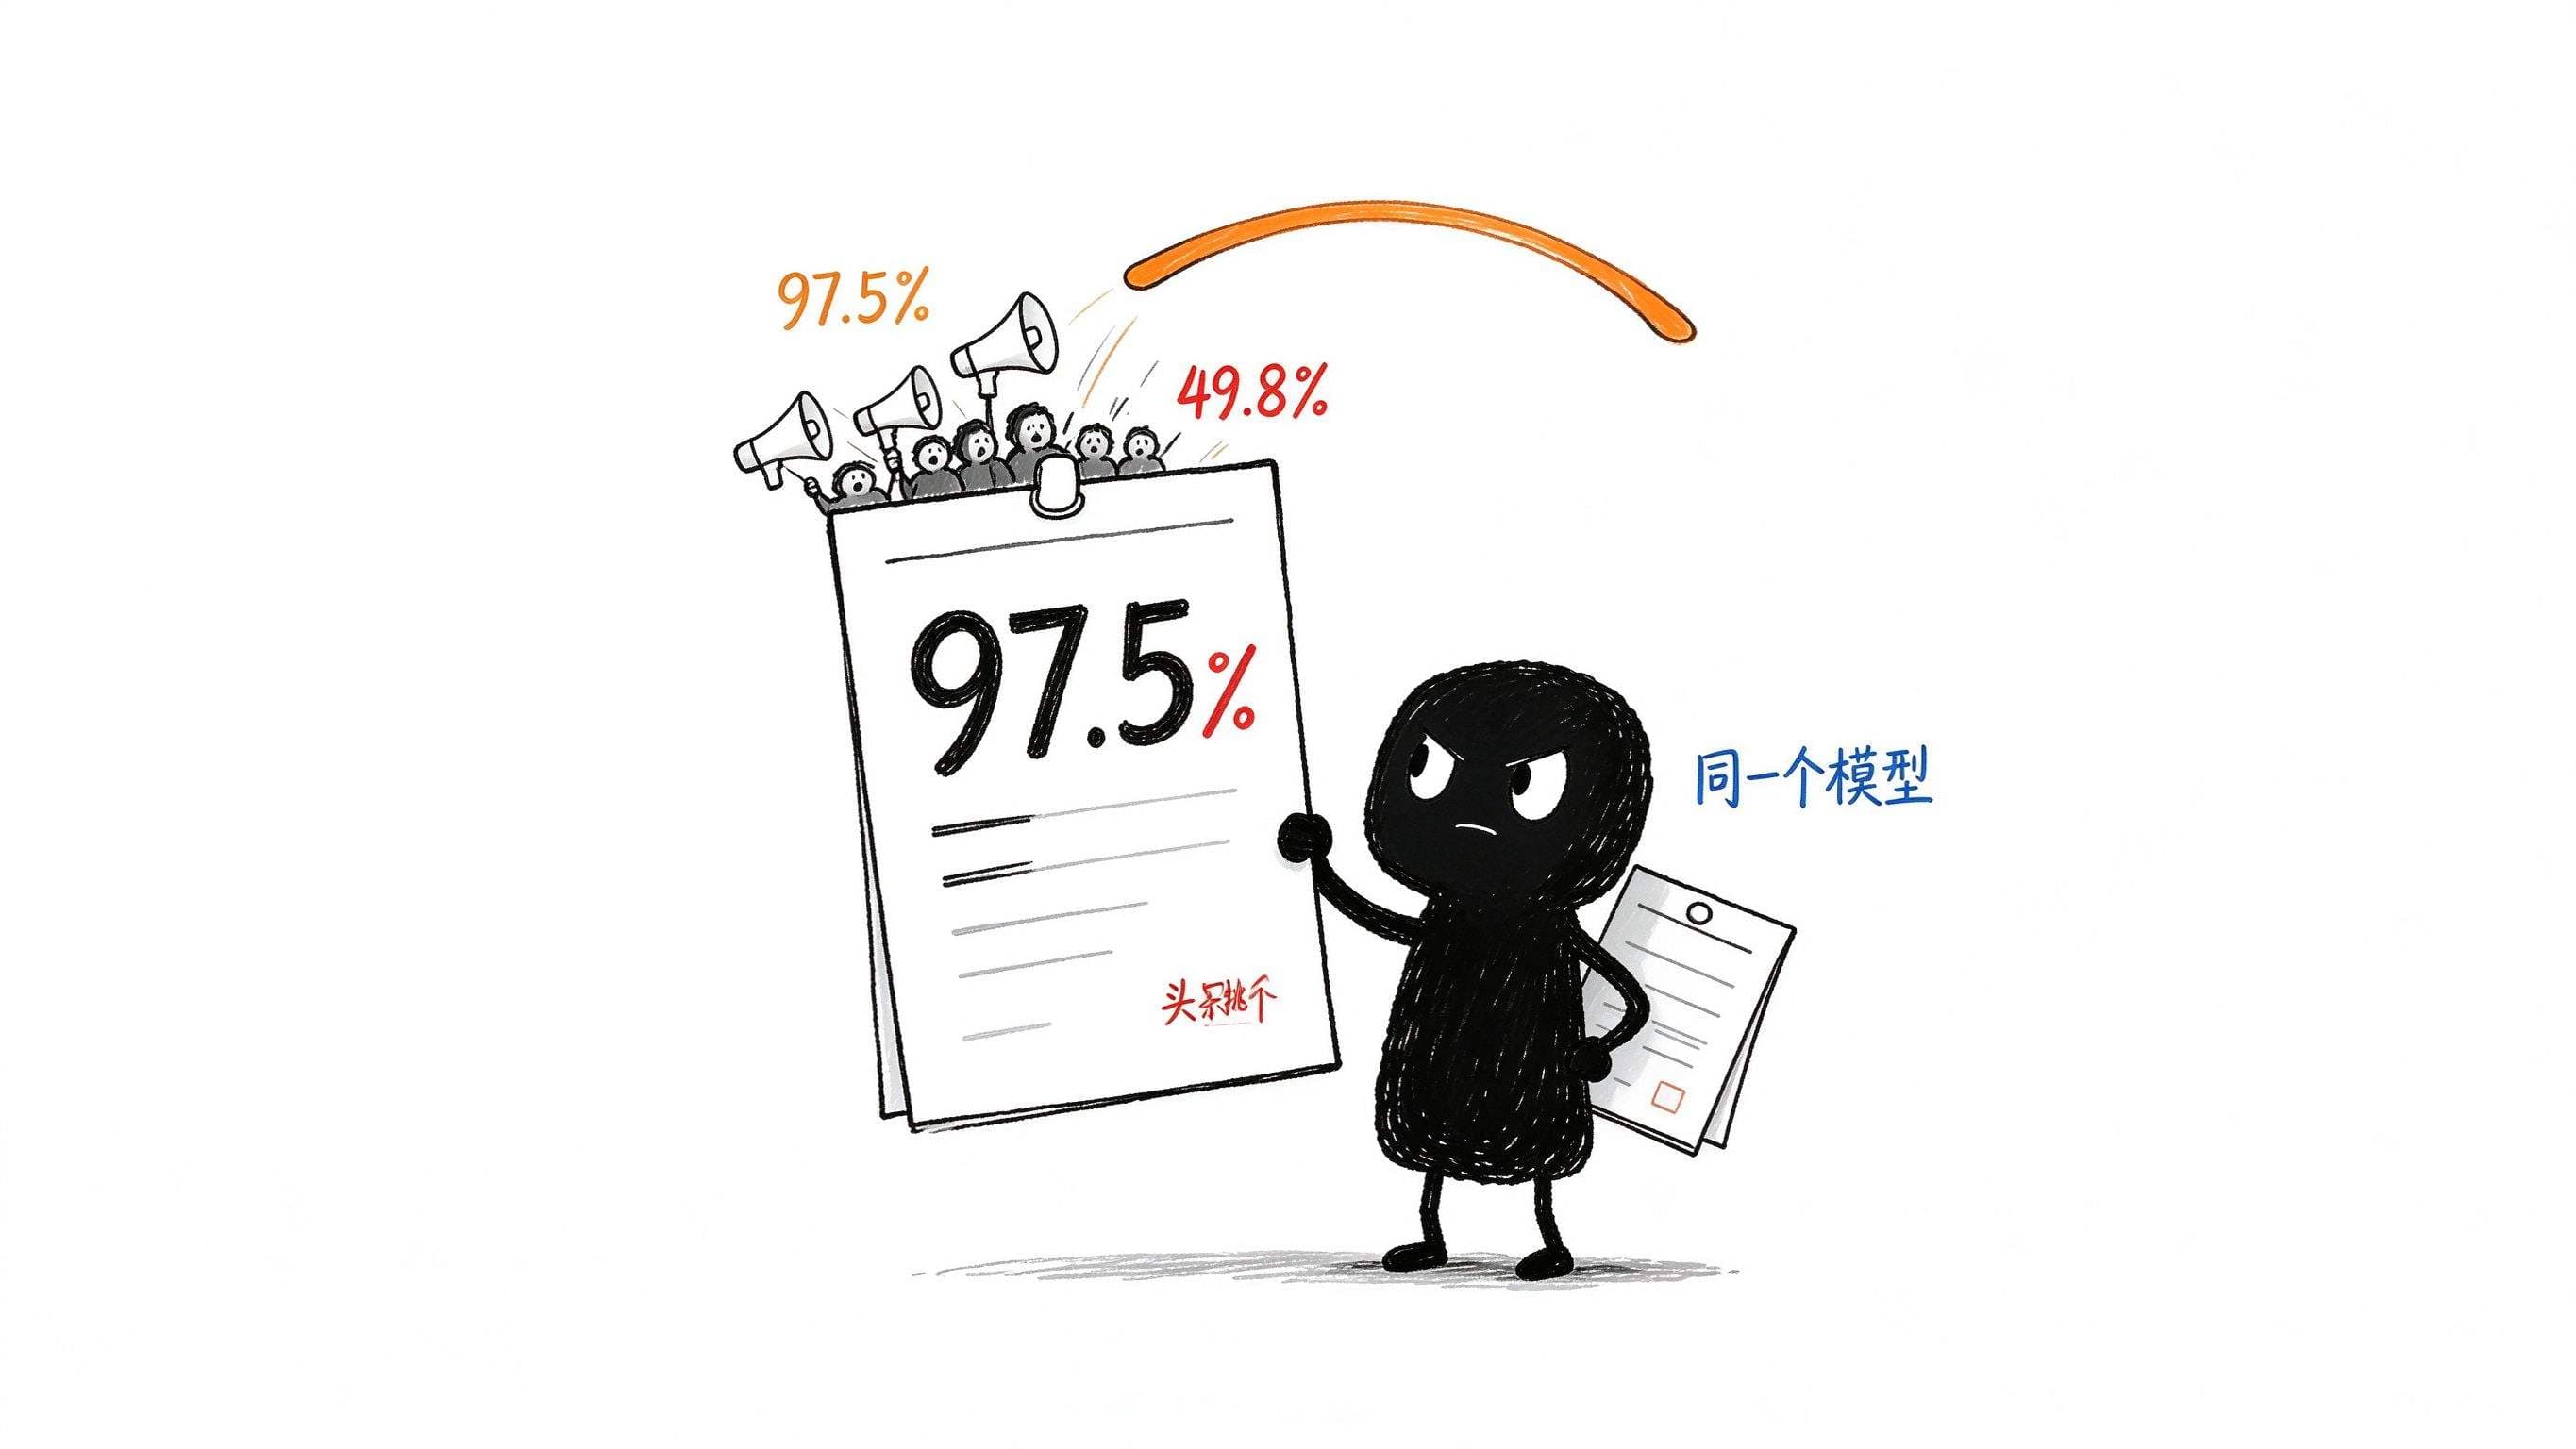
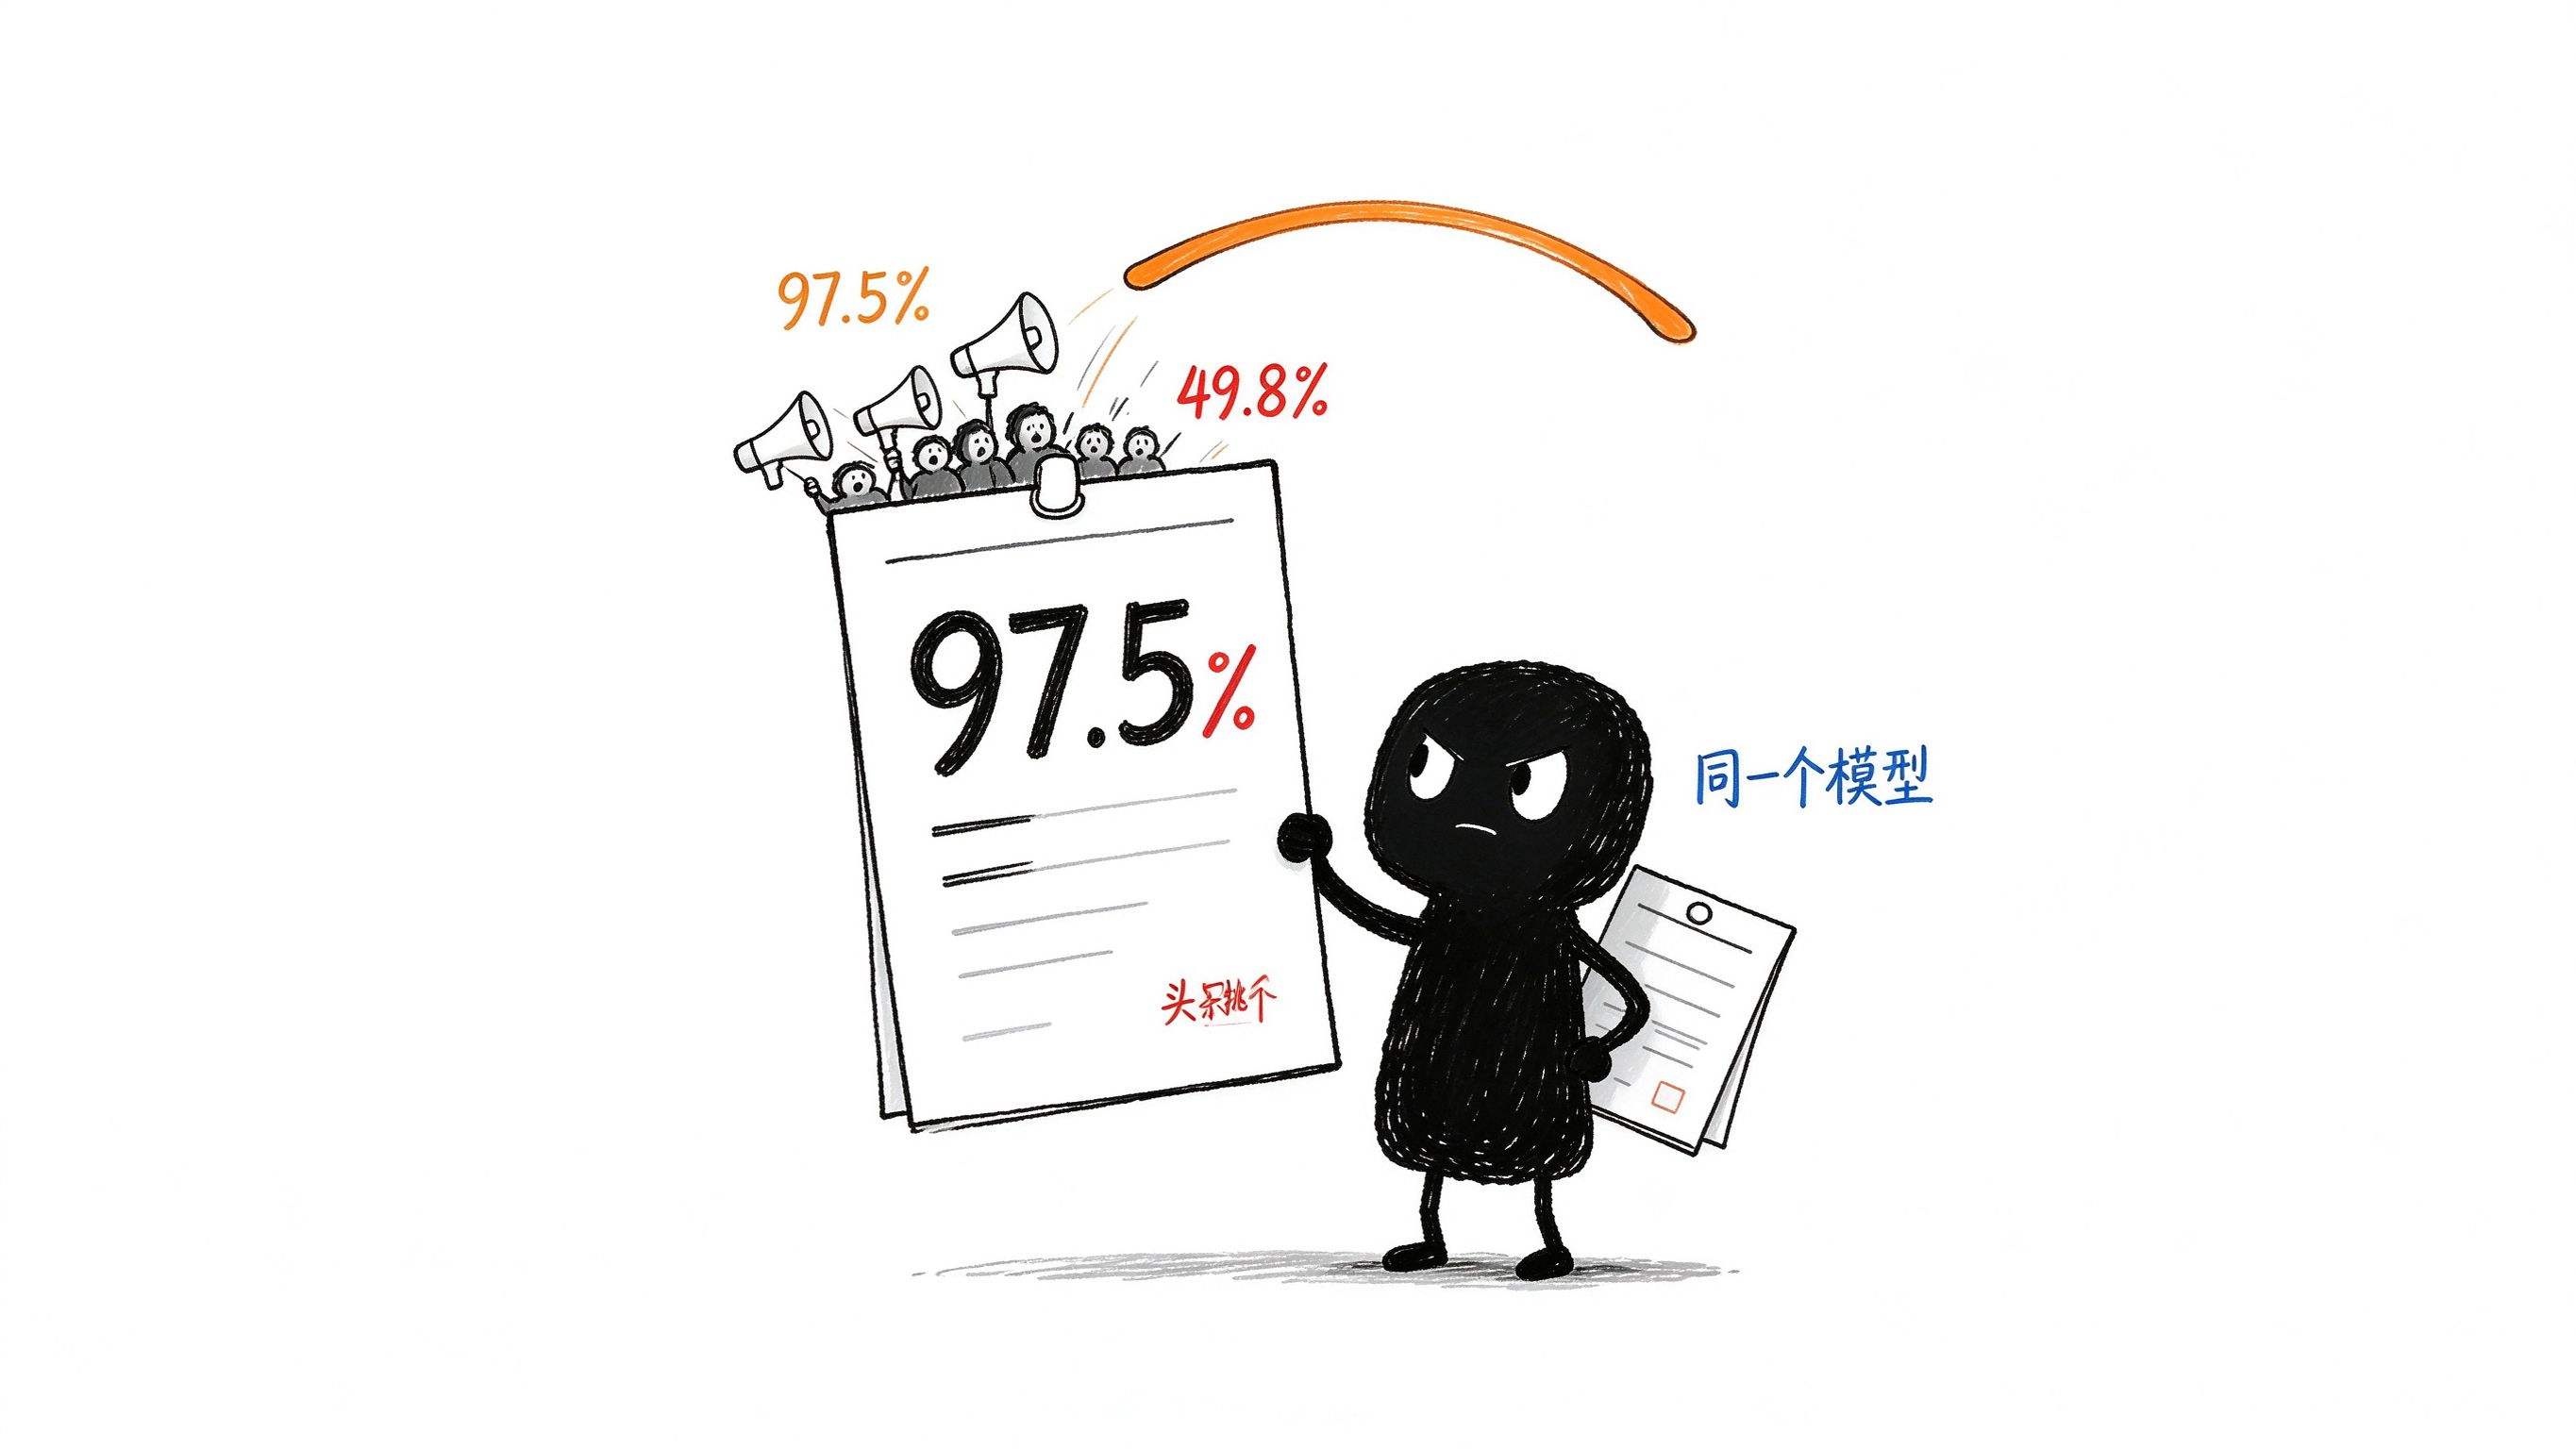
先说个暴论,现在你刷到的 AI 跑分,大多是玩具。
不是说它们是假的,数字都是真跑出来的。我说它是玩具,是因为同一个模型,换一下考场规则,分数就能从一半变成满分,而你在头条上永远只看得到其中一个。
这事得从一部电影说起。诺兰有部老电影叫《记忆碎片》,男主得了一种怪病,记不住十几分钟以前的事。他只能靠拍立得照片和满身纹身提醒自己,这个人可信,那个人别信,我在找谁。
我今天才反应过来,现在最聪明的一批 AI,参加过的最难的一场考试,考场几乎就是照着他设计的。
事情是这样的。今天凌晨,ARC Prize 发了 Gemini 4 Argon 的 ARC-AGI-3 成绩,97.5%,Google DeepMind 成了第二家冲过 95% 的实验室。热闹完往后看,同一条推文里还躺着另一个数,49.8%。同一个模型,同一套游戏,只是换了个考场,分数差了一倍。
要讲清楚这一倍是怎么来的,得先说说这场考试有多变态。
ARC-AGI-3 把 AI 扔进一堆它从没见过的像素小游戏。没有说明书,没有目标,连哪个方块是自己都不告诉你,全靠一步步试出来,最后还要跟人类比谁用的步数少。这种考法,考的就是一边玩一边记住刚才学到了什么。
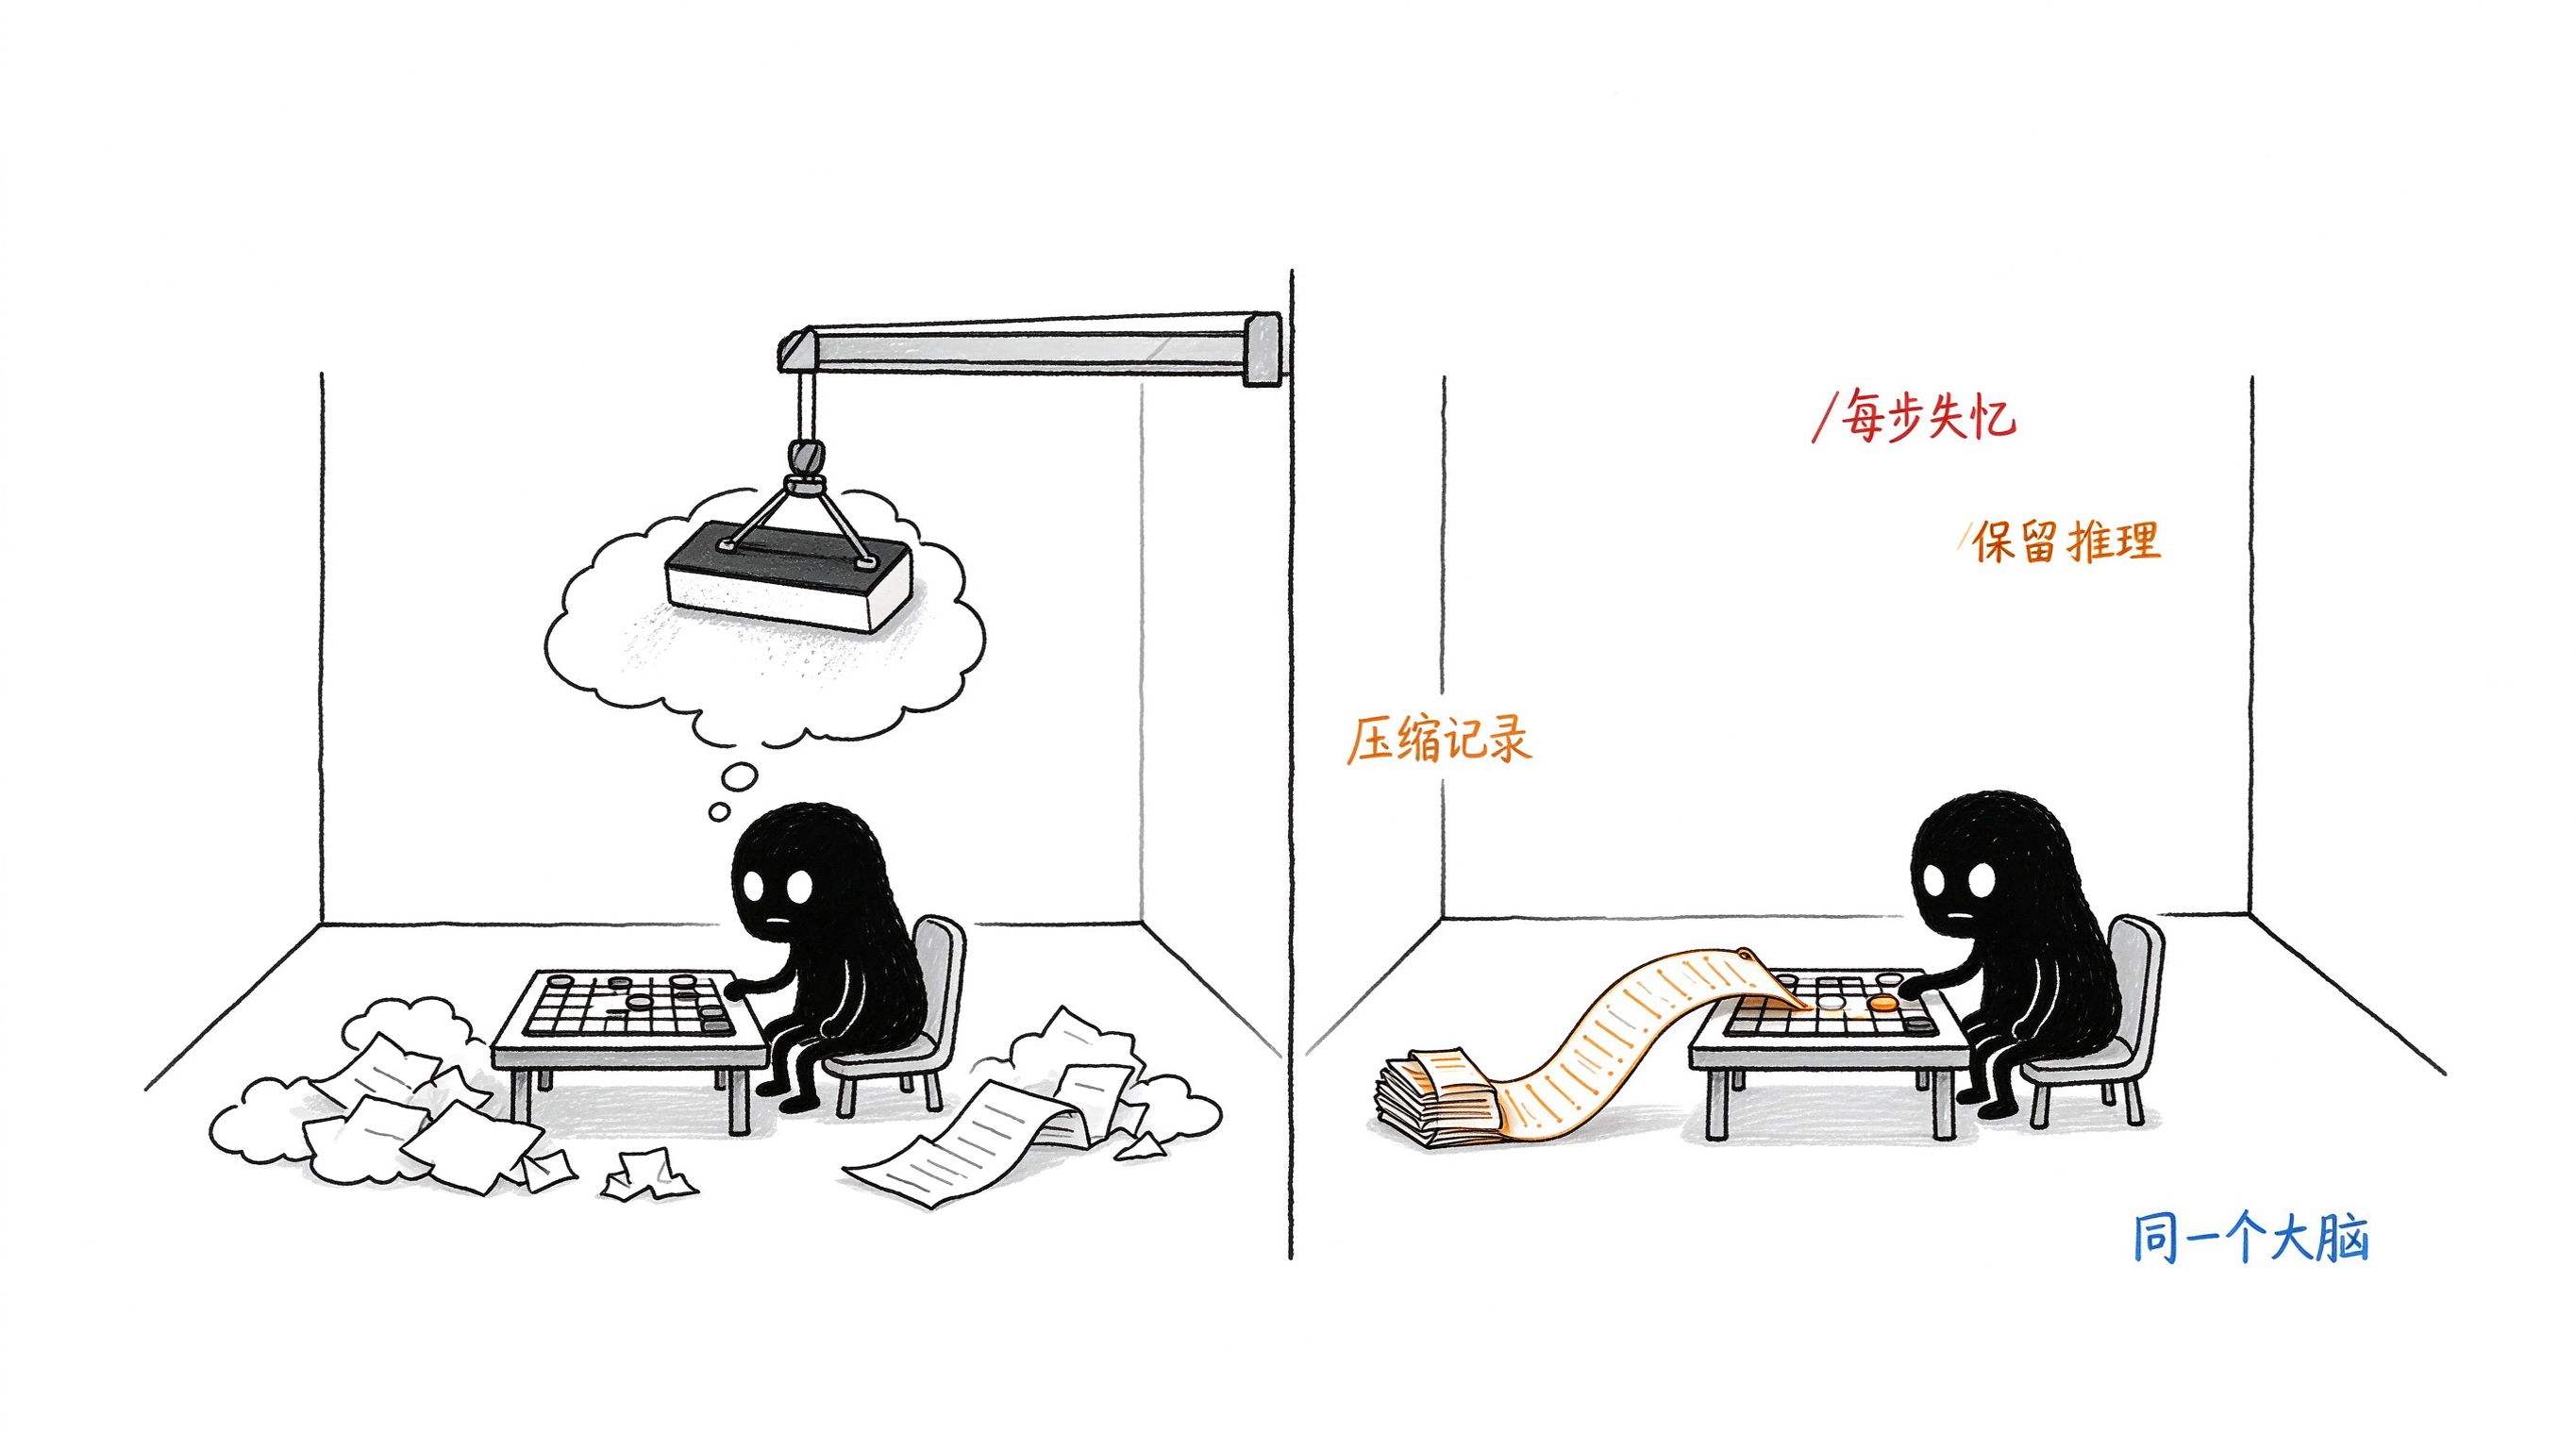
然后,考场规定,每走一步,把你脑子里刚才想的东西全部清空。
我没开玩笑。按 OpenAI 七月的说法,ARC 的官方框架在模型每走一步之后,会把它的私有推理全部丢掉,模型只看得到自己走过哪几步,看不到当时为什么这么走。历史太长了,还会从最早的记录开始删。唯一能带走的,是模型自己选择写下来的一点笔记。
拍立得都给你准备好了。
在这个考场里,GPT-5.6 Sol 考了 7.8%。这个模型啃过数学猜想,通关过宝可梦火红,还在 Codex 里连打五个小时赢下了《杀戮尖塔2》的每日挑战,结果在小方块游戏面前,像个第一天上学的小孩。上一代 GPT-5.5 更惨,0.4%,基本属于进了考场找不到座位。OpenAI 自己也看不下去了,回头翻游戏记录,发现模型每一步都在重新琢磨这个游戏到底怎么玩,琢磨到一半,走一步,又忘了。
于是 OpenAI 干了一件很简单的事,把两个开关打开。一个是保留推理,一个是记录太长时压缩成摘要,别直接删。
同样在公开题集上,Sol 从 13.3% 涨到 38.3%。更离谱的是,它用的输出 token 只剩原来的六分之一。八月我专门写过一篇《AI终于学会了「记住自己在想什么」》聊这件事,那时候我以为故事到这儿就讲完了。
原来模型那么费劲,有一大半是在一遍遍重新想起自己是谁。
说真的,ARC 那边也有它的道理。考场越朴素,越能看清模型本身的斤两,要是允许每家自带装备,比的就成了谁家装备好。九月,ARC 想了个两全的办法,考场一分为二。原来的叫标准框架,《记忆碎片》不变;新开一间厂商适配框架,允许模型带着自己的记忆进场。两边成绩分开公布,各写各的。
第一个两间都考过的是 GPT-6 Astra。记忆碎片房 62.7%,有记性的那间 99.9%。而且有记性的那间还更便宜,因为它不用每一步都重新想一遍人生。
有了记性的 Astra 有多夸张呢?ARC 找了大约 500 个普通人来玩同一批游戏,按每一关通关步数的中位数定了人类基准。在有记性的那间考场里,Astra 在 96% 的关卡上用的步数比人类还少,平均每关少用一半多。一个刚才还在每步失忆、对着像素发呆的模型,带上记忆以后,玩起陌生游戏比路人还利索,这反差多少有点好笑。
我最喜欢 ARC 博客里的一个细节。Astra 在记忆碎片房里给自己写的笔记,长这样,extend8 to3; retract10 to2; shorten8 to1。像暗号,像速记,像一个被反复失忆折磨出来的人,学会了把最重要的东西压成几个字符,刺在身上。
被逼到绝境的模型,自己发明了一套纹身文字。
好,那现在回到今天这张成绩单。
97.5% 是在有记性的那间考的,49.8% 是在记忆碎片房考的。连 ARC 自己那条推文,第一句写的也是 97.5%,标题自然全跟着它走。
但子弹回旋镖,往往就藏在这里。
七月,OpenAI 的意思很明确,记忆碎片房冤枉了模型,有记性才是真实的工作方式。这话没毛病。可三个月过去,有记性那间的分数已经挤到了天花板,Astra 99.9%,Argon 97.5%,几乎分不出谁高谁低。再想知道哪个模型更强,大家只能回头去看,谁在记忆碎片房里考得更好。
当初被嫌弃的那间考场,现在成了唯一还能分出高下的地方。
ARC 也是这么看的。按 OfficeChai 的报道,ARC 认为能在标准框架下把 ARC-AGI-3 解决掉,才是更有意义的门槛。顺带一提,Argon 在记忆碎片房里还遇上了 API 故障,55 个游戏只跑完 42 个,所以这个 49.8% 多少有点委屈,更像一个下限。
回旋镖飞回来,没有砸中任何一家公司,砸中的是我们看分数只看一个的习惯。
当然,这事也别想过头,以为只要给够记性,什么模型都能考满分。有个叫 Schema 的社区框架,逼模型把每个游戏的规则写成程序,再拿全部历史逐条验证。有一局里,模型在自己的笔记里老老实实写了一句,我对方块的理解完全错了,然后推倒重来,后面几关越打越顺。可同样是给足装备的框架,换个弱一点的底层模型,分数照样能差出几十个百分点。
记性能放大一个模型的本事,但没法凭空变出本事。
最后算一笔让我有点破防的账。Astra 在有记性那间考出 99.9%,平均每个游戏花了三百多美元。ARC 估算过,人类测试者玩一个游戏,大脑耗的那点能量换成电费,还不到一美分的十分之一。
几十万倍的差距。人类一边记着刚才发生了什么,一边顺手把游戏玩了,这件我们每天都在做、从来不觉得是本事的事,今天的 AI 要花几百美元才勉强做到。
所以回到开头那句暴论。跑分是玩具,但玩具也分两种,一种拿来炫耀,一种拿来拆开看里面的零件。今天这张成绩单,97.5% 是前一种,括号里的 49.8% 和它背后那套失忆考场,才是后一种。
下次你再看到一个漂亮的跑分,先别急着鼓掌,问一句,它考试的时候,被允许记住自己是谁吗?
如果你自己在搭 Agent,这个问题可以直接拿去问自己的代码。很多框架默认就是每轮丢掉推理、超长就砍掉最早的记录,你的模型也许每天都在演一遍《记忆碎片》。
谢谢你看我的文章,我们,下次再见。
/ 作者:青玉白露
评论区
欢迎留下你的看法,支持匿名评论。
你的评论会公开展示,建议填写便于交流的昵称,并尽量提供有信息量的反馈。